분자정보 저장 시스템
제3강 (3주차-1) · DNA 인코딩 단계 — 디지털 데이터에서 DNA 서열로
DNA Hacking Challenge | ASCII · UTF-8 · 음성 · 이미지 · JPEG · 영상 | DNA 서열의 제약 | 2진 · 3진 · ATGC 인코딩
송영준 Youngjun Song, Ph.D. · 인천대학교
← → 이동S 목차R 읽기 모드F 전체화면
오늘의 학습 성과
학습 목표 6가지
- 컴퓨터 안의 모든 파일이 "바이트 열"임을 hexdump로 확인
- ASCII·UTF-8·음성·이미지(JPEG)·영상이 비트로 표현되는 원리 설명
- JPEG에서 비트 하나의 오류가 왜 치명적인지 설명
- DNA 서열 제약(호모폴리머·GC·Tm·이차구조) 5가지를 열거·설명
- 1 bit/nt · 2 bits/nt · 3진(Goldman) 인코딩을 손으로 수행
- 인코딩 밀도(bits/nt)와 제약의 교환관계 계산
인코딩 = "비트를 염기로 바꾸는 규칙" · 규칙은 자유롭지 않음 — DNA의 화학이 허락하는 서열만 쓸 수 있음
오늘의 지도
75분 · 4개 파트 · 퀴즈 2회
DNA Hacking Challenge
5분
디지털 데이터의 코딩
25분
DNA 서열의 특징
10분 + 퀴즈
2진 · 3진 · ATGC 인코딩
15분 + 퀴즈
디지털 데이터가 "무엇으로" 되어 있는지 먼저 → DNA가 "무엇을 허락하는지" → 둘을 잇는 규칙(인코딩)
오늘 손으로 한 인코딩을 Python(Google Colab)·MATLAB Online으로 자동화 · 자기 이름을 DNA로 · 노트북 필수
Can you hack DNA?
DNA Hacking Challenge — Nick Goldman, WEF 2015
- DNA 시험관 속에 넣은 1 Bitcoin — 먼저 해독하는 사람이 가져간다
- Goldman & Birney, Nature (2013) — 무엇을 어떻게 저장했나
- "그러면 여러분도 오늘 DNA를 해킹해 봅시다" → 인코딩 실습
Opening — Can you hack DNA?
World Economic Forum 2015 · "Future Computing: DNA Hard Drives" · Nick Goldman (EMBL-EBI) · 16분 26초
▶ youtube.com/watch?v=tBvd7OSDGgQ (썸네일 클릭)
WEF 공식 채널 · 영어 자동 자막 · 아래 인용은 WEF 영상 설명의 key quotes
| 영상 흐름 (클립 포인트) | Goldman의 말 | |
|---|---|---|
| ① | DNA = 자연의 하드드라이브 | "네 종류 분자를 어떤 순서로든 이어 붙일 수 있고, 다시 읽으면 문자열 — 디지털 코드라고 생각해도 된다" |
| ② | 시퀀싱 비용의 급락 | 10년 전 게놈 1개 = 런던 최고가 주택 → 지금 = 아스널 시즌권 가격 |
| ③ | DNA에 메시지 숨기기 | "우리가 저장하는 정보는 전부 DNA에 관한 것 — 그렇다면 DNA 자체가 저장매체가 될 수 있다" |
| ④ | 무엇을 저장했나 | 셰익스피어 소네트(.txt) · MLK "I Have a Dream"(.mp3) · Watson–Crick 1953 논문(.pdf) → Agilent 합성 → "시험관 바닥의 먼지 한 톨" |
| ⑤ | 읽기는 쉽고 쓰기는 비싸다 | "세상의 모든 정보를 DNA에 넣을 수는 있지만, 그럴 돈이 지구에 없다" — 쓰기가 속도 제한 단계 |
| ⑥ | 장기 보존 | 매머드 2만 년 · 고대 말 70만 년 DNA 판독 · "춥고 건조한 곳이면 된다" · 대통령 기록·핵폐기물 위치·가족사진 |
전체를 틀지 않고 ④→⑤ 구간(파일 → DNA → 시험관 먼지 → 읽기/쓰기 비용)만 재생 · 나머지는 표로 요약 · 재생 구간은 수업 전 한 번 확인
DNA Hacking Competition — 다보스 비트코인 챌린지
2015년 1월 21일 WEF 무대 → 2018년 1월 해독 · 3년짜리 공개 현상금
DNA 시험관 배포
private key (당시 약 $200)
하는 사람이 가져감 · 3년
(Antwerp 박사과정) 해독
약 4~5주
| Wuyts가 막힌 곳 | 이번 주 개념 |
|---|---|
| Illumina MiSeq 2,300만 read → 117 nt 길이 필터 | 올리고 설계 · 인덱스/payload 구조 |
| 3진 인덱스 + parity trit 체크섬 | Goldman 3진 인코딩 · 오류 검출 |
| 미공개 keystream(랜덤화) — 가장 오래 막힘 | 인코딩 명세 없이는 복원 불가 ★ |
| 필터가 너무 엄격해 유효 read 폐기 | 오류율 vs coverage 교환 |
| Huffman 코드표 필요 | 가변길이 부호 = 코드북 없으면 못 읽음 |
- 9개 파일 중 5개 복원 — 비트코인 키 지시문·PDF·로고 2개·James Joyce 사진
- 가장 오래 막힌 지점은 화학이 아니라 소프트웨어 — "어떤 규칙으로 썼는지"
- DNA를 시퀀싱하는 것과 데이터를 디코딩하는 것은 다른 일 · 인코딩 명세 = 사실상 암호키
- 출처: Wuyts 본인 블로그 write-up · EMBL-EBI 보도자료
2강: 파일은 조각(올리고)으로 · 오늘: 조각 안의 비트 → 염기 규칙 · 4강: parity·ECC · 11강: read 조립 — Wuyts가 4주 동안 거친 길이 곧 이 과목의 목차
Goldman et al., Nature (2013) — 무엇을 저장했나
"Towards practical, high-capacity, low-maintenance information storage in synthesized DNA" · Goldman & Birney, EMBL-EBI
| 저장 파일 5개 (총 739 kB) | 형식 |
|---|---|
| ① 셰익스피어 소네트 154편 | .txt (ASCII) |
| ② Watson–Crick 1953 논문 | |
| ③ EMBL-EBI 사진 | .jpg |
| ④ MLK "I Have a Dream" 발췌 26초 | .mp3 |
| ⑤ Huffman 코드표 자체 — 자기서술(self-describing) | .txt |
- 153,335 올리고 × 117 nt · 100-nt 세그먼트를 75 nt씩 겹쳐 4중 중복 · 교대 reverse complement · 인덱스 + parity trit
- 바이트 → Huffman → 3진수 → 직전 염기를 피하는 회전 매핑 (호모폴리머 0) → PART 4에서 손으로 해 본다
- 복원 100% (1개 파일은 50 nt 수동 보정) · 실효 밀도 약 0.33 bits/nt — 4중 중복의 대가
- 2017 DNA Fountain(1.57 bits/nt)이 "10배 개선"이라 불리는 이유 · 같은 논문도 $50 기프트카드를 숨겨 트위터 팔로워가 해독
- ⑤번 파일에 주목 — 코드표를 DNA에 같이 넣음 · "미래의 누군가가 스스로 해독할 수 있게" (아카이브 철학)
파일 → 0/1 → A/T/G/C → 서열 제약(GC · 호모폴리머 · 길이) → Index + Payload + ECC → DNA 서열 생성 · 오늘은 이 규칙을 배우고(PART 2~4), 다음 시간에 Python·MATLAB으로 직접 인코딩 · ECC(4강)와 디코딩(11강)까지 가면 일부러 넣은 오류에서 원본을 되살리는 디코딩 실습으로 이어진다
디지털 데이터의 코딩
What Is Digital Data Made Of?
- bit · byte · 16진수 — 파일은 바이트 열
- ASCII · UTF-8 — 글자를 숫자로
- 음성 · 이미지 · JPEG · 영상 — 신호를 숫자로
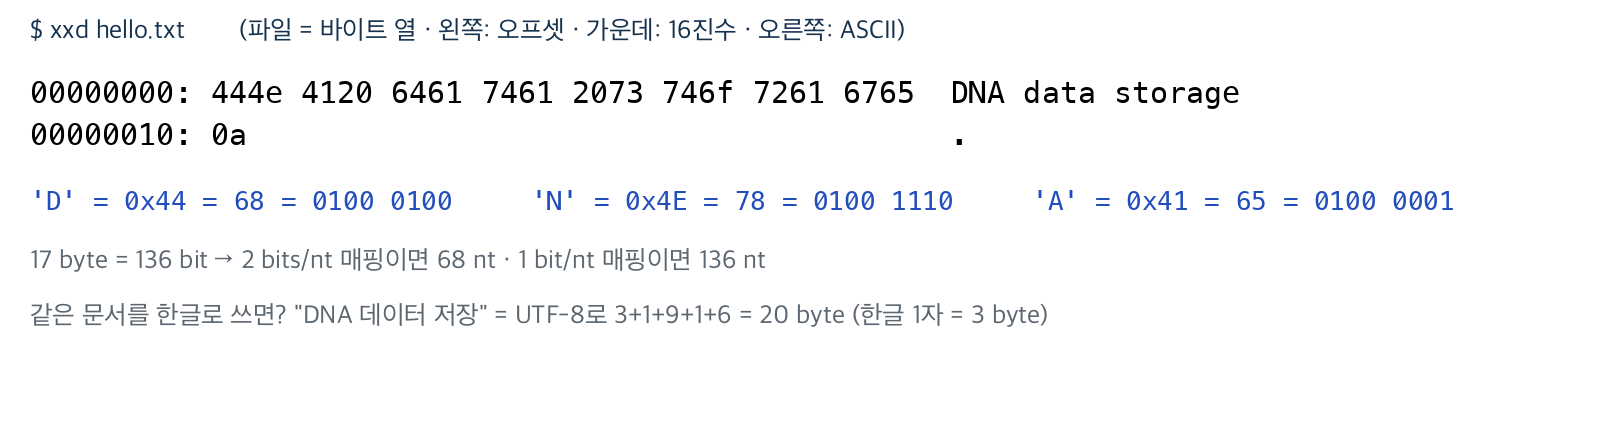
디지털 데이터란 — 파일은 바이트 열
bit → byte → 16진수 → 파일
| 단위 | 크기 | 예 |
|---|---|---|
| bit | 0 또는 1 | 트랜지스터 1개 · 염기 반 개(2 bits/nt 기준) |
| byte | 8 bit = 256가지 | 영문 1글자 · 픽셀 한 색 채널 |
| KB / MB / GB | 10³ / 10⁶ / 10⁹ byte | 문서 · 사진 · 영화 |
| TB / PB / EB / ZB | 10¹² / 10¹⁵ / 10¹⁸ / 10²¹ | HDD · 데이터센터 · 국가 · 전 세계(연 200 ZB) |
- 컴퓨터의 모든 것 = 0/1 · 8개 묶음 = 1 byte
- 16진수(hex) = 4 bit씩 묶어 0~F로 표기 · 1 byte = 두 자리
- 파일 확장자(.txt .jpg .mp3)는 "해석 규칙" 표시일 뿐 · 내용은 전부 바이트 열
- DNA 저장의 입력도 결국 이 바이트 열 → 어떤 파일이든 같은 파이프라인
- 1 KB = 1,000 B(SI) vs 1 KiB = 1,024 B — 논문 용량 비교 시 주의
ASCII 문법 — 글자를 숫자로
American Standard Code for Information Interchange (1963) · 7 bit · 128 코드
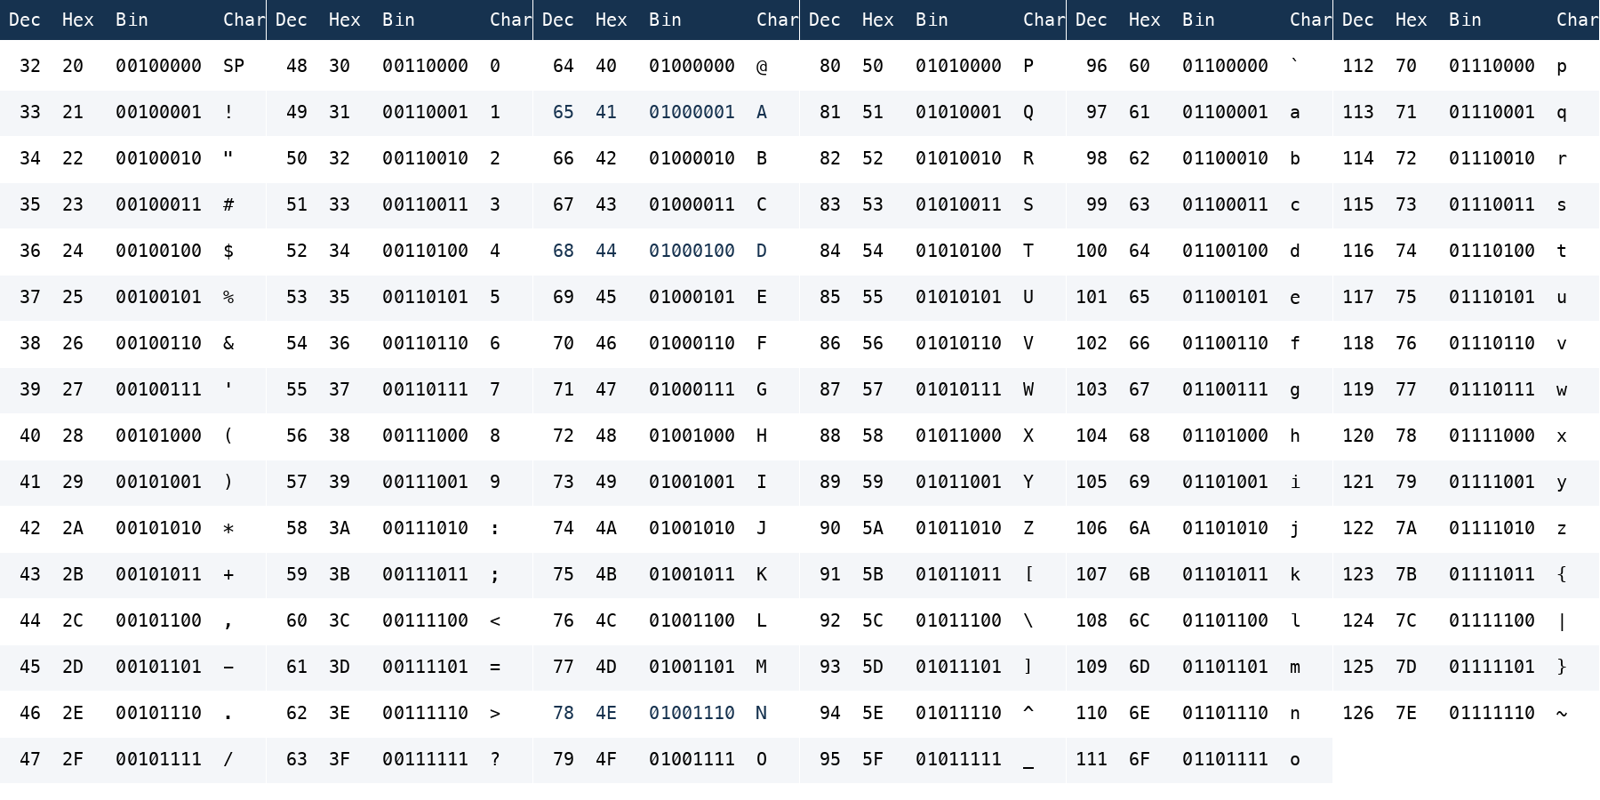
- 0~31 제어문자(줄바꿈 10, 탭 9) · 32 공백 · 127 DEL
- 48~57 = 숫자 0~9 (0x30~0x39)
- 65~90 = A~Z (0x41~) · 97~122 = a~z (0x61~)
- 대·소문자 차이 = 32 = 0x20 = bit 5 하나
- 8번째 bit는 0 → 확장 ASCII(128~255)는 지역마다 다름
- 한글은? → Unicode · UTF-8: 1~4 byte 가변, 한글 1자 = 3 byte
- "송" = U+C1A1 → EC 86 A1
ord('A') → 65 chr(65) → 'A' format(65, '08b') → '01000001' '송'.encode('utf-8') → b'\xec\x86\xa1' (Python)
double('A') → 65 char(65) → 'A' dec2bin(65, 8) → '01000001' unicode2native('송','UTF-8') → [236 134 161] (MATLAB)음성 · 노래 — 파형을 숫자로
표본화(sampling) · 양자화(quantization) · 압축
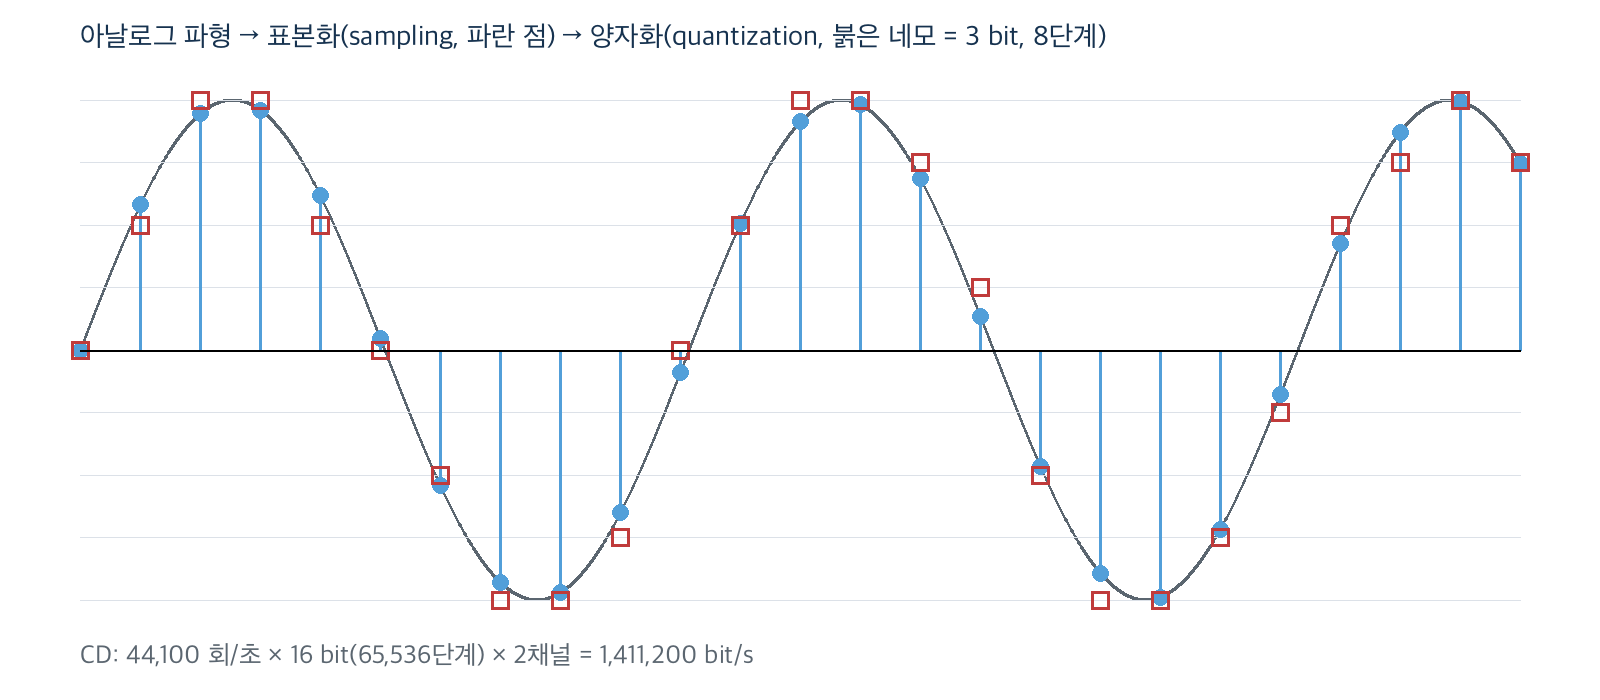
- 표본화: 초당 몇 번 재는가 — Nyquist: 최고 주파수의 2배 이상
- 사람 가청 20 kHz → CD 44.1 kHz
- 양자화: 한 번 잴 때 몇 bit — CD 16 bit = 65,536 단계
- CD 음질 = 44,100 × 16 × 2채널 = 1,411 kbit/s
- 3분 노래(WAV) = 1,411,200 × 180 ÷ 8 ≈ 31.7 MB
- MP3 128 kbit/s ≈ 2.9 MB — 약 1/11 · 귀에 안 들리는 성분 제거(심리음향)
- 저장 관점: 압축 = 중복 제거 → 압축 파일은 비트 하나가 더 소중해짐
10분짜리 강의 녹음(모노 16 kHz 16 bit)은 몇 MB인가? → 16,000 × 16 × 1 × 600 ÷ 8 = 19.2 MB · 2 bits/nt면 약 7,700만 nt
이미지 — 픽셀을 숫자로
pixel · RGB · 해상도 · 원시 크기
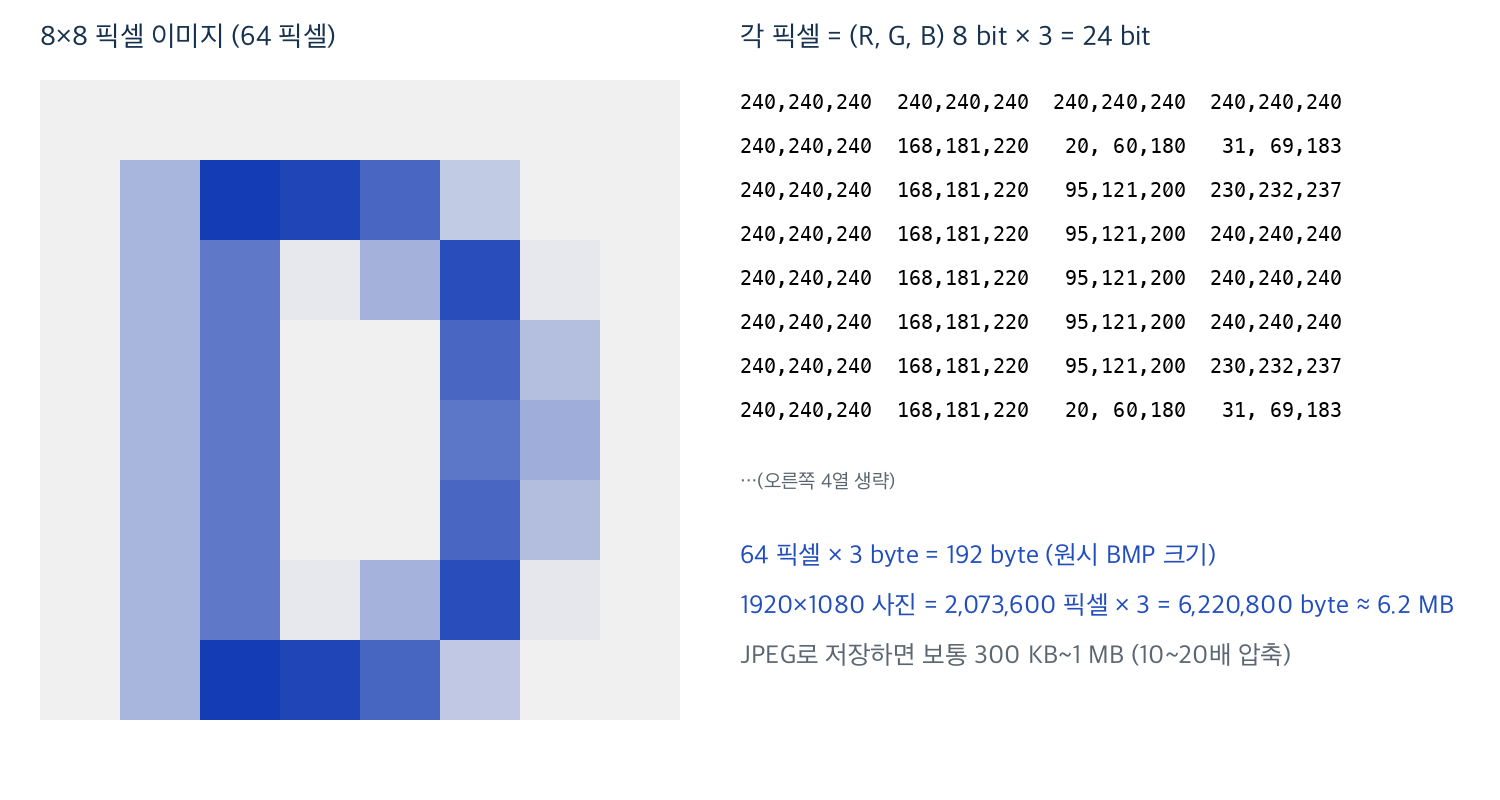
- 이미지 = 픽셀의 격자 · 픽셀 = (R, G, B) 각 8 bit → 24 bit = 1,677만 색
- 해상도 1920×1080 = 207만 픽셀 → 원시(BMP) 6.2 MB
- 흑백(1 채널) 8 bit · 의료영상 12~16 bit · 투명도(알파) 추가 시 32 bit
- PNG = 무손실 압축(zip과 유사) · JPEG = 손실 압축(다음 장)
- Shipman GIF: 36×26 픽셀 × 5프레임 → 색 하나를 염기 코드 3가지 중 하나로(축퇴) → 제약 회피
내 폰 12 MP 사진(4000×3000)의 원시 크기는? → 12,000,000 × 3 = 36 MB · JPEG로 3~4 MB · 2 bits/nt면 약 1.4억 nt = 150 nt 올리고 약 100만 종
JPEG 코덱 — 손실 압축의 여섯 단계
사람 눈이 못 보는 것을 버린다
밝기/색차 분리
색 해상도 1/4
DCT주파수 성분으로
= 품질 계수
0이 뒤로 몰림
가변길이 부호
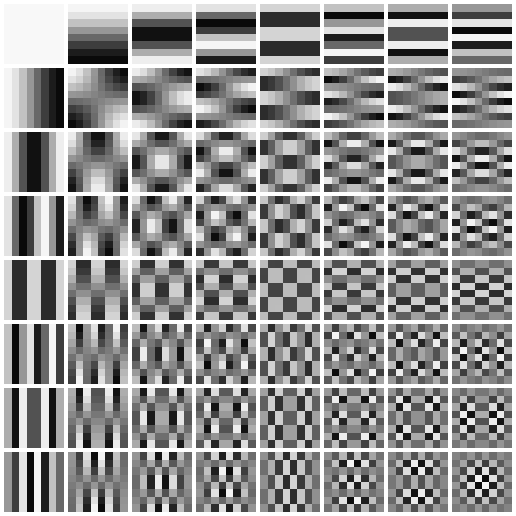
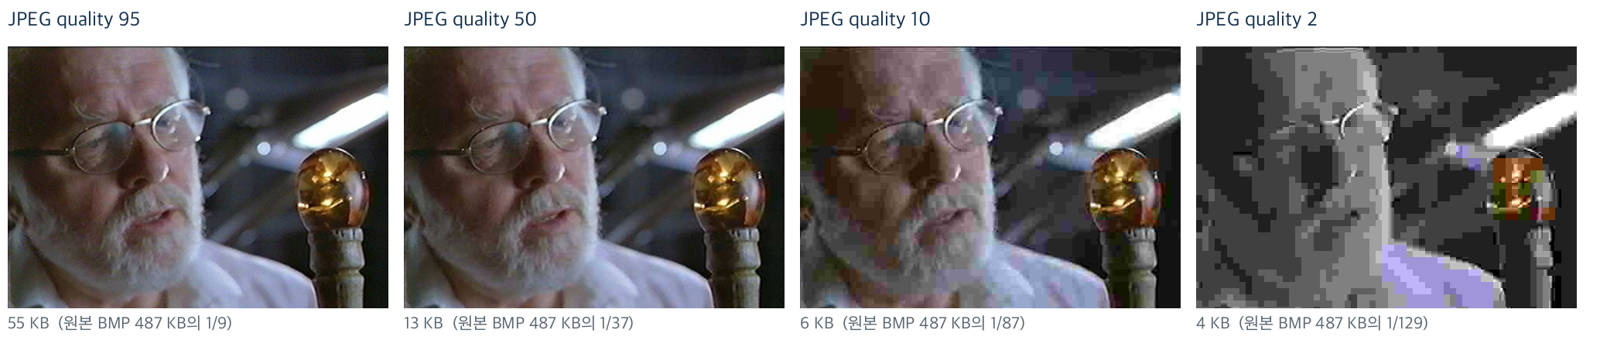
③ DCT는 정보를 버리지 않음(가역) · ④ 양자화가 유일한 손실 단계 · ⑥ Huffman은 길이가 제각각인 부호 → 비트 하나 틀리면 그 뒤가 전부 어긋남
JPEG에서 비트 하나가 틀리면
압축 파일과 오류 전파 — DNA 저장에 ECC가 필수인 이유
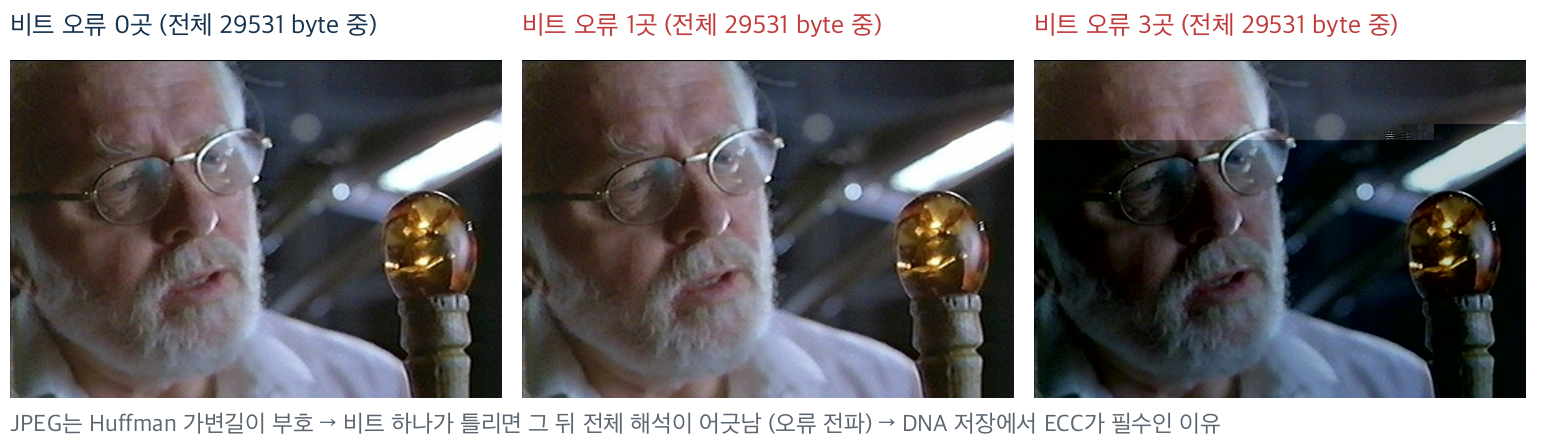
- 29,531 byte 중 1 byte만 바뀌어도 그 지점부터 화면이 깨짐
- 가변길이(Huffman) 부호는 "경계"가 데이터에 의존 → 한 비트가 어긋나면 경계가 밀림 = 동기화 상실
- 원시 BMP였다면 픽셀 하나만 틀림 · 압축률이 높을수록 비트 하나가 무거워짐
- DNA 채널의 오류는 치환뿐 아니라 삽입·삭제 — 압축 파일에는 최악의 조합
- → 4강 ECC: 오류를 "있어도 고칠 수 있게" 만드는 층을 인코딩 위에 얹음
2강 "DNA 저장 = 통신 채널" · 오늘 "압축 데이터는 오류에 약함" · 4강 "그래서 ECC" — 세 장이 한 줄로 이어짐
영상 데이터 — 프레임의 흐름
fps · I/P/B 프레임 · H.264/H.265
| 항목 | 원시(raw) | 압축(H.264) |
|---|---|---|
| 1080p · 30 fps · 1초 | 1920×1080×3 byte×30 ≈ 187 MB (1.5 Gbit/s) | 약 0.6~1 MB (5~8 Mbit/s) |
| 1시간 영화 | 약 670 GB | 약 2~4 GB |
| 압축률 | — | 200~300 : 1 |
| 4K · 60 fps | 약 12 Gbit/s | 약 25~50 Mbit/s |
- 영상 = 이미지 × 시간 · 24~60 프레임/초
- I 프레임: JPEG처럼 독립 압축 · P/B 프레임: 앞(뒤) 프레임과의 "차이"만 저장
- 움직임 보상(motion compensation) — 블록이 어디로 움직였는지만 기록
- 시간축 중복 제거 → 압축률 수백 배 · 대신 I 프레임이 깨지면 그 뒤 여러 프레임이 함께 깨짐
- DNA 저장 시연에서 영화(Erlich 2017)·GIF(Shipman 2017)가 자주 쓰이는 이유 — "압축된 무거운 비트"의 대표
글자·소리·그림·영상 → 전부 바이트 열 · 압축은 중복을 없애 비트를 무겁게 만듦 → DNA에 넣기 전 "무엇을 어떻게 지킬지"가 인코딩 설계
DNA 서열의 특징
Sequence Constraints — What DNA Allows
- 호모폴리머 · GC 함량 · Tm
- 이차구조 · 반복 · 금지 서열
- 제약이 곧 인코딩 규칙의 출발점
DNA 서열의 제약 ① — 호모폴리머 · GC 함량 · Tm
"쓸 수 있는 서열"과 "쓸 수 없는 서열"
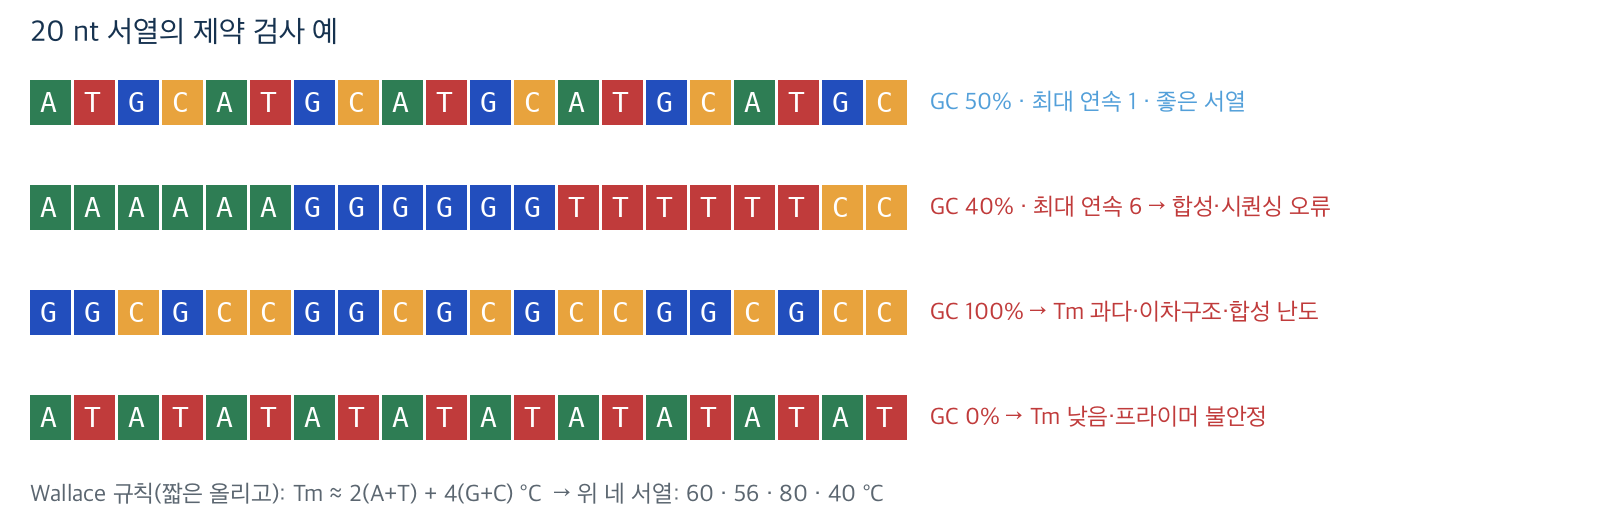
"AAAA"가 왜 "ACAC"보다 위험한가? 시퀀서가 A를 4개 읽었는지 5개 읽었는지 어떻게 아는가?
- 호모폴리머(homopolymer) — 같은 염기 연속
- 합성 시 미끄러짐(slippage) · 나노포어·pyrosequencing은 길이를 세지 못함 → 보통 ≤ 3~4
- GC 함량 — 전체 중 G+C 비율
- 40~60%(엄격히 45~55%) · 낮으면 Tm↓·프라이밍 불안정, 높으면 이차구조·합성 난도·PCR 편향
- Tm(녹는점) — 이중가닥의 절반이 풀리는 온도
- Wallace: Tm ≈ 2(A+T) + 4(G+C) °C (≤ 20 nt) · 정확히는 최근접이웃(nearest-neighbor) 열역학
- 한 pool 안의 올리고들은 Tm이 비슷해야 같은 PCR 조건에서 균일 증폭
나노포어(Delahaye 2021): 호모폴리머 ≥ 8이면 정확도 25% 이하 · 전체 오류의 47%가 호모폴리머 구간 · Twist 합성 절대 한계 14 bp · Erlich 2017 규칙: ≤ 3, GC 45~55%
DNA 서열의 제약 ② — 이차구조 · 반복 · 금지 서열
"더 있나?" — 있다: 길이 · 플랫폼 특성
| 제약 | 무엇인가 | 왜 문제인가 | 설계 규칙 |
|---|---|---|---|
| 이차구조 | 한 가닥 안에서 상보 부위가 접혀 헤어핀 형성 | PCR·시퀀싱 중합효소가 멈춤 · 합성 수율↓ | 접힘 자유에너지 ΔG > −3 kcal/mol 등 · 자기상보 회피 |
| 반복 · k-mer | 같은 k-mer가 여러 올리고에 등장 | 클러스터링·정렬 혼동 · 잘못된 조립 | 올리고 간 편집거리(edit distance) 확보 · 해시(5강) |
| 금지 motif | 제한효소 인식서열 · 프라이머 유사 서열 | 비의도 절단 · 프라이머 교차결합(random access 오염) | 금지 목록 검사 후 재인코딩 |
| 길이 | 올리고 150~300 nt | 합성 사이클 누적 오류(0.995ⁿ) | 파일을 조각내고 인덱스 부여 (2강) |
| 플랫폼 특성 | 나노포어: 호모폴리머 · Illumina: GC 편향 | 읽기 오류 유형이 시퀀서마다 다름 | 목표 시퀀서에 맞춘 제약 강도 (10강) |
제약을 만족하는 서열은 전체 4ⁿ 중 일부 → nt당 정보량이 2 bits보다 작아짐 · 얼마나 작아지는지 = 인코딩 설계의 성적표(bits/nt) → PART 4
퀴즈 1 — DNA 서열의 특징
옆 사람과 30초씩 대화 후 답변
힌트 — 신호가 같은 상태로 머묾 · 길이를 세는 문제 · 나노포어 전류·pyrosequencing 광량
힌트 — 4 °C × 20 = 80 °C · 균일 PCR 조건 · 이차구조
힌트 — 어떤 염기 다음에 올 수 있는 염기의 수 · 4 vs 3 · log₂3 = 1.585
2진 · 3진 · ATGC 인코딩
Mapping Bits to Bases
- 2 bits/nt 직접 매핑과 1 bit/nt(Church)
- 3진 회전 매핑(Goldman) — 제약을 규칙 안에 넣기
- 밀도 비교와 전체 인코딩 파이프라인
"DNA"를 DNA로 쓰기 — 세 가지 매핑
ASCII 24 bit → 12 nt / 24 nt / 15 nt
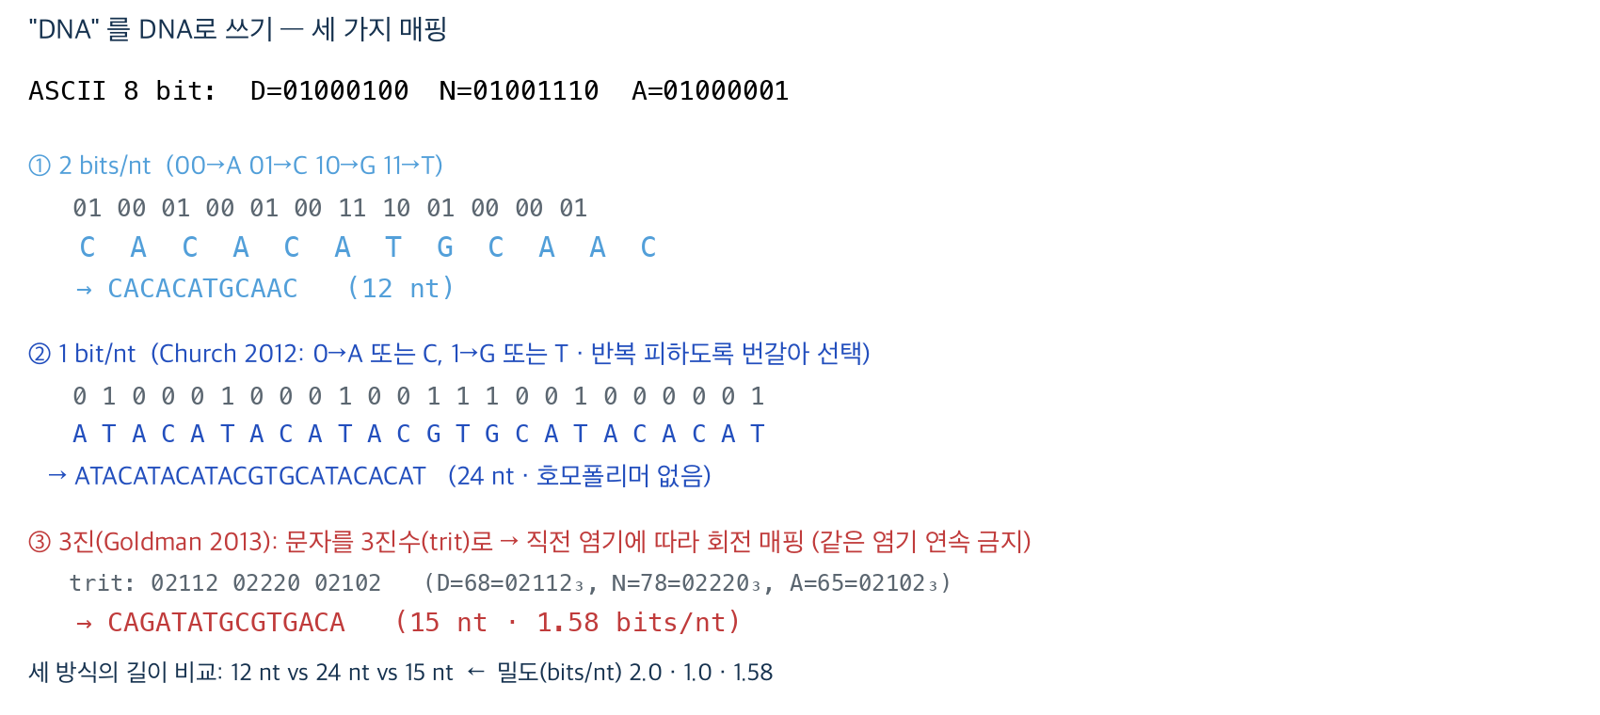
- ① 2 bits/nt 직접 매핑 — 00 A · 01 C · 10 G · 11 T
- 가장 조밀(2.0 bits/nt) · 그러나 00000000 → AAAA 호모폴리머 그대로 노출
- ② 1 bit/nt (Church 2012) — 0 → A 또는 C, 1 → G 또는 T
- 같은 비트가 이어져도 다른 염기를 고를 수 있어 호모폴리머 회피 · 밀도 1.0
- ③ 3진 회전 (Goldman 2013) — 다음 장
- 밀도 1.58 · 호모폴리머 원천 차단
'MIT'를 ①로 바꾸면 CATCCAGCCCCA — GC 66.7% · CCCC → 두 제약을 동시에 위반 · 3줄 코드의 결과가 방금 배운 규칙을 다 어김 · 자기 이름 첫 글자도 해 보기
3진 회전 매핑 — Goldman et al., Nature (2013)
제약을 "규칙 안에" 넣는 첫 번째 방법
| 직전 염기 | trit 0 | trit 1 | trit 2 |
|---|---|---|---|
| A | C | G | T |
| C | G | T | A |
| G | T | A | C |
| T | A | C | G |
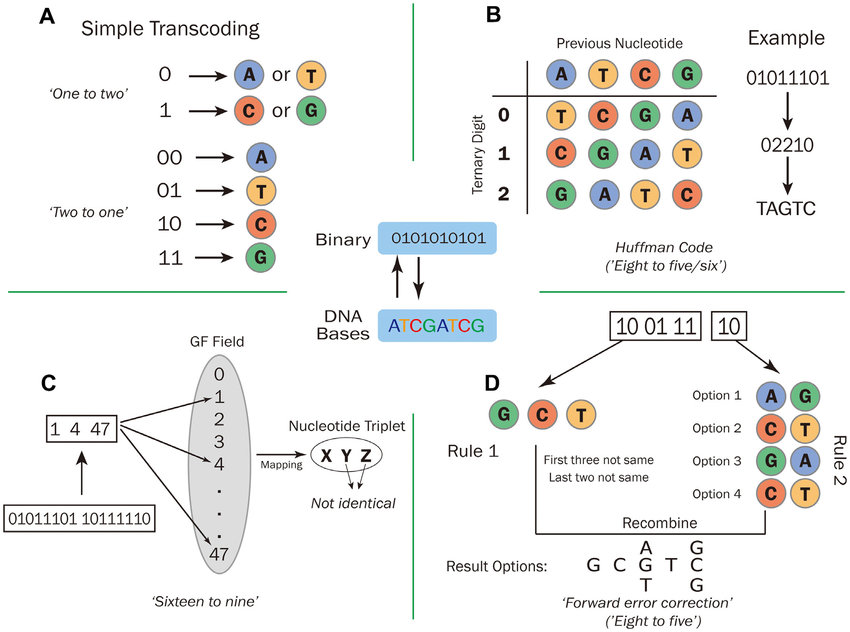
⚠ 문헌마다 표의 배열이 다름(왼쪽 그림 B는 A→T C G) · 원리는 같지만 호환 불가 — 표를 모르면 못 읽음(다보스 사례)
길이 2 bits/nt 대비 26% 증가 · 대신 검사 없이도 제약 보장
- 1 단계: 바이트 → Huffman 부호 → 3진수(trit 0/1/2)
- 2 단계: 직전 염기를 제외한 3개 중 trit로 선택
- 같은 염기가 연속될 수 없음 → 호모폴리머 길이 항상 1
- 밀도 log₂3 = 1.585 bits/nt · 실제 Goldman 1.58
- 예: "D" = 68 = 02112₃ · 직전 A → C A G A T
- 회전표는 어떤 순열이든 가능 · 핵심은 "직전 염기 제외"
① "먼저 조밀하게 쓰고 나쁜 서열은 걸러낸다"(DNA Fountain, 5강) vs ② "규칙 자체가 나쁜 서열을 못 만들게 한다"(Goldman) · 밀도와 단순성의 교환
인코딩 밀도 비교 — bits/nt
coding potential (규칙 자체의 밀도)
| 방식 | 규칙 | bits/nt | 호모폴리머 | 비고 |
|---|---|---|---|---|
| 1 bit/nt | 0→A/C, 1→G/T | 1.00 | 회피 가능 | Church 2012 · 단순 · 길이 2배 |
| 3진 회전 | trit → 직전 제외 3택1 | 1.58 | 원천 차단 | Goldman 2013 · Huffman 필요 |
| 1 byte → 5 nt | 256 값 ↔ 제약 만족 5-mer 표 | 1.60 | 표에서 제외 | Blawat 2016 · 룩업 테이블 |
| 2 bits/nt 직접 | 00 A 01 C 10 G 11 T | 2.00 | 노출 | 가장 조밀 · 사후 검사 필요 |
| 2 bits/nt + 선별 | 직접 매핑 후 나쁜 서열 폐기·재생성 | 1.98 | 검사로 제거 | Erlich 2017 DNA Fountain |
| 이론 상한 (≤3 제약) | 제약 만족 서열 수의 극한 | ≈1.98 | — | 2강 과제 · 점화식 |
규칙이 강할수록 밀도가 낮고, 밀도를 높이려면 "검사 + 재시도"가 필요 · 반직관: ≤3 제약 자체의 손실은 1%(2.00 → 1.98)뿐, 1.98 → 1.57로 깎는 주범은 인덱스·ECC·중복 오버헤드
실제 예 — ASCII → DNA 매핑
"DNAdata Stores Apple" (203 bp)
| 글자 | ASCII (hex · bin) | DNA (8 nt, ECC 포함) |
|---|---|---|
| D | 44 · 01000100 | CCCTTCGA |
| N | 4E · 01001110 | CGCTACTT |
| A | 41 · 01000001 | ACTACACT |
| @ (구분자) | 40 · 01000000 | GTACGTGGA |
- 글자 하나 = 8 nt → 1 bit/nt 급 밀도 · 대신 각 8 nt 안에 오류 검출용 규칙(ECC) 내장
- 문장 4개를 각각 200 bp 안팎의 올리고로 — 2강의 T4 Ligase 병렬 체결 실험 데이터
- A. DNAdata Stores Apple (203 bp) · B. JamesWatson Likes Orange (220 bp)
- C. FrancisCrick Likes Grape (220 bp) · D. JohnVonNeumann Has Apple (217 bp)
- 전기장 합성 칩 위에서 합성 → 시퀀싱 → 복원 실험에 쓴 실제 인코딩
- 다음 시간 실습에서 같은 문장을 우리 규칙(2 bits/nt)으로 인코딩해 길이를 비교
연구실의 실제 데이터로 "인코딩 규칙은 설계자가 정한다"는 것을 확인 · 규칙을 알아야.
인코딩 전체 파이프라인 — 파일에서 올리고까지
오늘 배운 것을 2강의 올리고 구조에 끼워 넣기
바이트 열
(압축·암호화 선택)
분할 · 순서 번호
제약 검사
(4강)
(9강)
ATGC…
>oligo_0001 | file=name.txt | idx=0 ACGTTGCA...(primer 20)...CAGATATGCG...(index+payload)...TGCAACGT >oligo_0002 | file=name.txt | idx=1 ...
- 오늘 = 네 번째 칸(비트 → 염기)의 규칙
- 다섯 번째 칸(ECC)은 4강 · 여섯 번째(프라이머)는 9강
- 파일 이름·크기·해시 같은 메타데이터도 함께 인코딩 (5강 iSCAN 규칙)
- 출력은 FASTA 텍스트 — 이것이 합성 주문서이자 디코딩의 참조
이 파이프라인의 1~4번 칸을 Python·MATLAB 코드로 직접 짠다 · 입력: 자기 이름 · 출력: FASTA + GC%·최대 호모폴리머 길이
퀴즈 2 — 인코딩 계산
오늘 배운 내용으로 답변 가능
힌트 — 01 01 00 11 → ? · 0 1 0 1 0 0 1 1 → 8 nt
힌트 — 4 × 8 = 32 bit · 32 ÷ 2 · 32 ÷ 1.58
힌트 — 1 MB = 8×10⁶ bit · 올리고당 200 bit · 압축이 올리고 수를 6배 줄이지만 오류에는 약해짐
오늘의 정리
제3강(3주차-1) 핵심 여섯 문장
- 파일은 확장자와 무관하게 바이트 열 · hexdump로 확인 가능
- ASCII 7 bit · UTF-8 한글 3 byte · 소리는 표본화+양자화 · 그림은 픽셀×RGB · 영상은 그림×시간
- JPEG의 손실은 양자화에서만 · Huffman 가변길이 때문에 비트 하나 오류가 전파됨
- DNA는 호모폴리머·GC·Tm·이차구조·반복·금지서열 제약 아래서만 쓸 수 있음
- 1 bit/nt(1.0) · 3진 회전(1.58) · 2 bits/nt(2.0) — 규칙이 강할수록 밀도는 낮아짐
- 인코딩 규칙을 아는 사람만 읽을 수 있다 — 인코딩 명세 = 사실상 암호키 (다보스 사례)
bit · byte · hex · ASCII · UTF-8 · 표본화 · 양자화 · 픽셀 · RGB · DCT · 양자화 테이블 · Huffman · I/P/B 프레임 · 호모폴리머 · GC 함량 · Tm · 이차구조 · edit distance · coding potential · trit · 회전 매핑 · FASTA
다음 시간과 과제
3주차-2강 — 인코딩 실습: 내 이름을 DNA로
다음 시간 (3주차-2, 실습)
Python (Google Colab) · MATLAB Online 두 언어로
- 언어 소개 → 환경 설정 → 첫 코드 5줄 → 비교
- 8 bit 이론 → 이름 → 비트 → ATGC → FASTA
- GC% · 최대 호모폴리머 자동 계산 · 디코딩으로 되돌리기
준비물: 노트북 · Google 계정 · MathWorks 계정(학교 이메일)
이번 주 과제
① 자기 이름(영문)을 손으로 2 bits/nt 인코딩ASCII 표 → 8 bit → ATGC · GC%와 최대 호모폴리머 길이 기록
② 같은 이름을 Goldman 3진 회전으로 인코딩 (직전 염기 A에서 시작)trit 변환표 사용 · 길이 비교
③ 내 폰 사진 한 장의 JPEG 크기와 해상도로 원시 크기·압축률·필요 올리고 수 계산150 nt 올리고 · payload 100 nt · 2 bits/nt 가정
Goldman et al., "Towards practical, high-capacity, low-maintenance information storage in synthesized DNA", Nature (2013)
Erlich & Zielinski, "DNA Fountain enables a robust and efficient storage architecture", Science (2017)
Q and A
"인코딩 규칙을 아는 사람만 DNA를 읽을 수 있다."
송영준 Youngjun Song, Ph.D. · 인천대학교