분자정보 저장 시스템
제2강 · DNA 데이터 저장 프로세스와 역사
왜 DNA인가 | DNA 구조와 특징 | 저장 프로세스 5단계 | 역사 | 합성 DNA
송영준 Youngjun Song, Ph.D. · 인천대학교
← → 이동S 목차R 읽기 모드F 전체화면
디지털 데이터의 폭증과 "저장 격차"
생성되는 데이터의 대부분은 저장조차 되지 못함
- 전 세계 데이터 양 = 가속적·기하급수적 증가
- AI·빅데이터 2차·3차 가공 데이터, 클라우드·IoT·자율주행·디지털 전환
- 생성 데이터 중 실제 저장되는 비율
- 2018년 18% → 2030년 3% → 2040년 0.5% 전망
- 기존 데이터센터의 문제
- 비용: 2019년 820억 달러 → 2023년 1,250억 달러 (약 153조 원)
- 전력: 전 세계 전력의 약 3% · 국내 단일 센터 약 6,000만 kWh, CO₂ 2만 2,352 t
- 전자폐기물: 자기테이프 교체 수명 10년 · 전자장비 교체 주기 6~7년
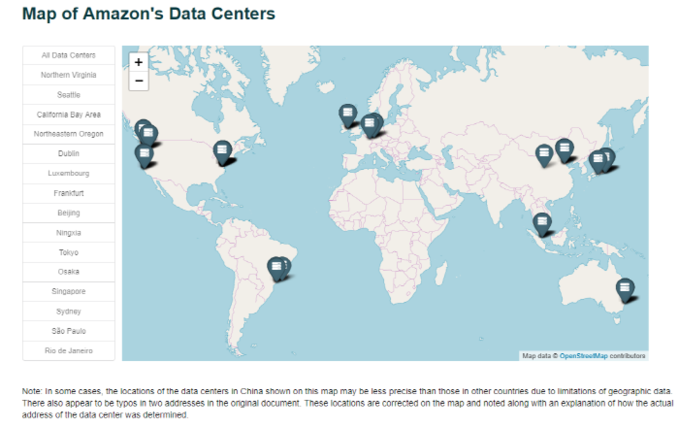
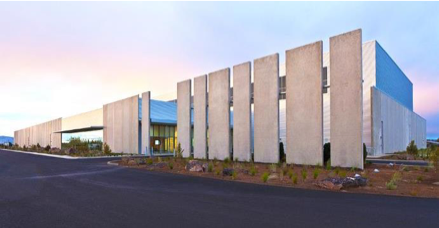
Amazon 데이터센터 분포와 외관 (AWS 공개자료)
데이터는 늘고 저장 능력은 못 따라감 · 밀도·전력·수명에서 한 자릿수가 아닌 "몇 자릿수" 개선이 필요한 매체
데이터를 트럭으로 옮기는 시대
Amazon Snowmobile — 최대 100 PB를 컨테이너 트럭으로 물리 운송
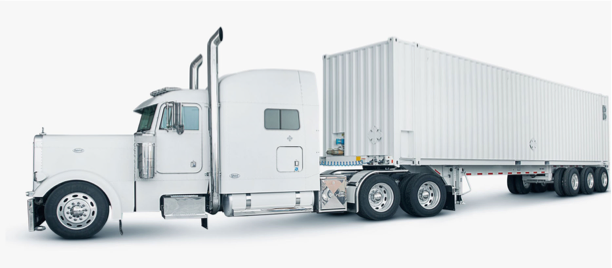
- 네트워크로 옮기기엔 너무 큰 데이터 → 트럭이 더 빠름 (100 PB ≈ 10 Gbps 회선으로 약 2.5년)
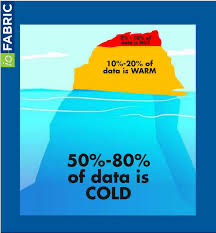
- 저장된 데이터의 50~80%는 콜드 데이터 — 거의 읽지 않지만 버릴 수 없음
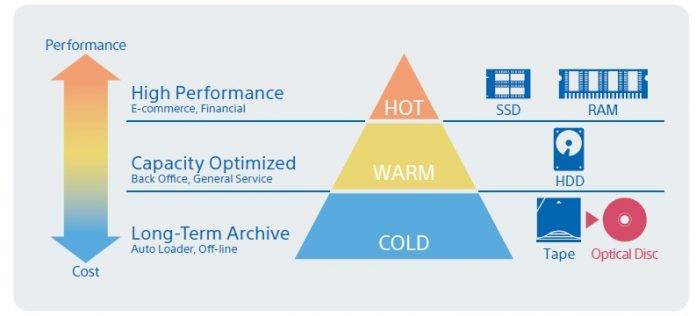
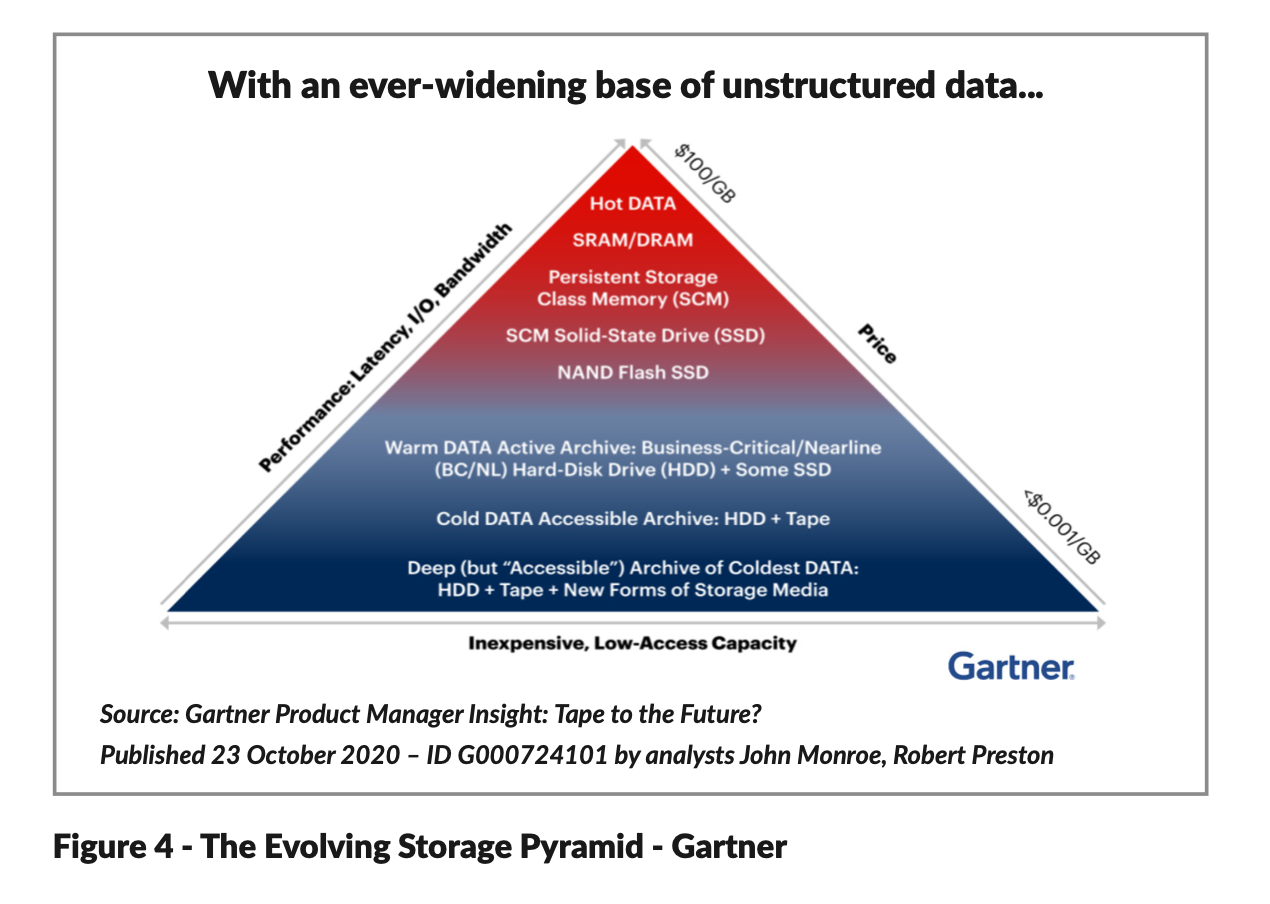
- Hot(SSD·RAM) → Warm(HDD) → Cold(Tape·광디스크) 계층 · 아래로 갈수록 용량↑ 비용↓ 지연↑
- DNA Data Storage Alliance의 첫 목표 시장 = 콜드 데이터 (정부·국방·은행·보험·미디어 아카이브)
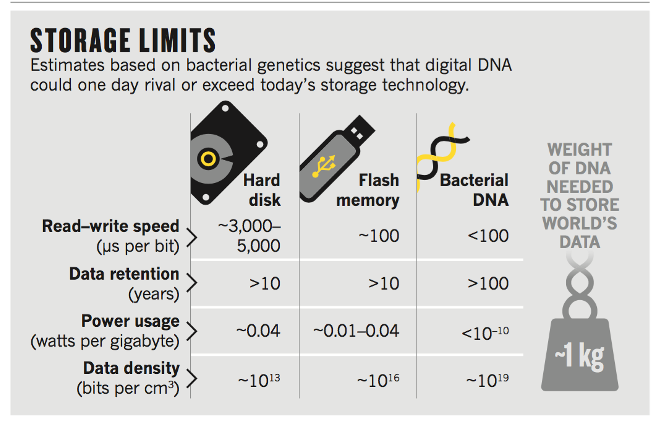
STORAGE LIMITS — 세 매체의 정면 비교
A. Extance, Nature (2017) · "DNA could store all of the world's data in one room"
영화 〈쥬라기 공원〉(1993) — 호박 속 모기 DNA에서 복원한 정보
- 읽기·쓰기 속도 — 비트 단위 비교는 타당 · 문제는 처리량과 준비 시간
- 데이터 보존 — 100년 초과 · HDD·플래시는 10년 초과
- 전력 — 10⁻¹⁰ W/GB 미만 · HDD 대비 10⁸배 낮음, 사실상 0
- 데이터 밀도 — 약 10¹⁹ bits/cm³ · 플래시(10¹⁶)의 1,000배
- "세계 데이터 전부 ≈ 약 1 kg" — 다음 슬라이드에서 직접 계산
표의 4행 중 DNA가 지는 것은 "속도" 하나뿐 · 나머지 셋(보존·전력·밀도)은 자릿수 단위로 이김 → 콜드 아카이브에 최적
수명 — 매머드의 증거
이론이 아닌 화석 기록
추출·시퀀싱된 DNA
가속열화(Arrhenius) 외삽 결과
(냉동고든 실온 건조 캡슐이든)
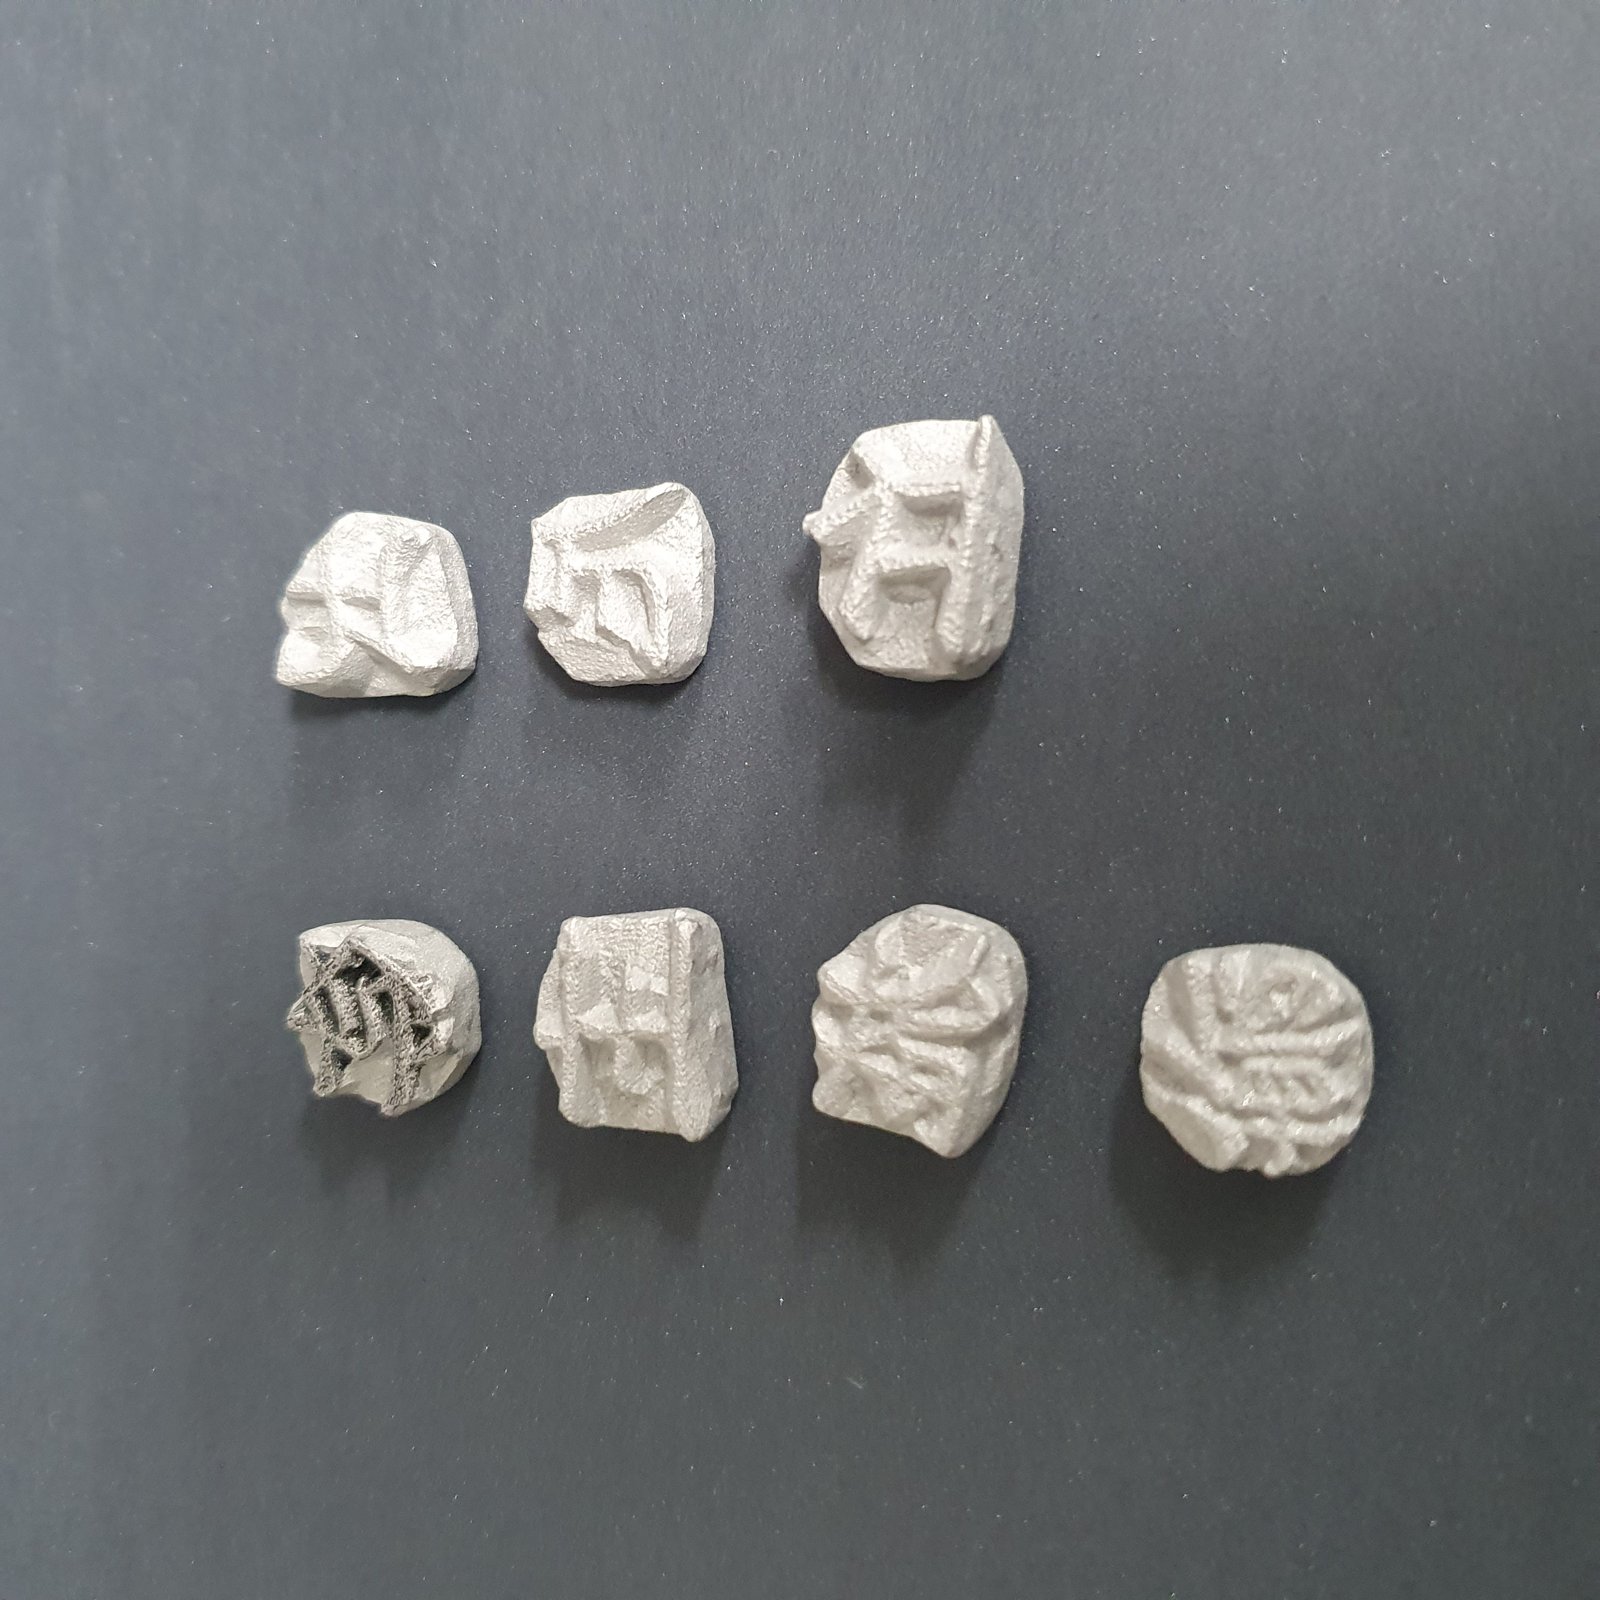
건조 DNA 펠릿 · "각설탕 한 개 부피의 DNA에 전 세계 데이터" 비유
- 단편화에도 판독된 매머드 DNA → 장기 보존의 목표 = "분자가 온전히"가 아닌 "정보가 복원 가능하게"
- 단편화·일부 소실에도 중복성·오류정정 코드가 있으면 원본 복원 가능 (4강 ECC)
- 가장 저평가된 장점 — 포맷 진부화 없음
- LTO 판독에는 전용 드라이브 필요 · 드라이브 단종 위험
- DNA 판독 능력은 생명과학이 존재하는 한 지속 · 매년 저렴·고속화
- 복제 비용도 거의 0 · PCR 한 번으로 지수 증폭 (PART B)
저장 매체로서 DNA의 여섯 가지 성질
P. Stanly et al., Biotechnology Advances (2020)
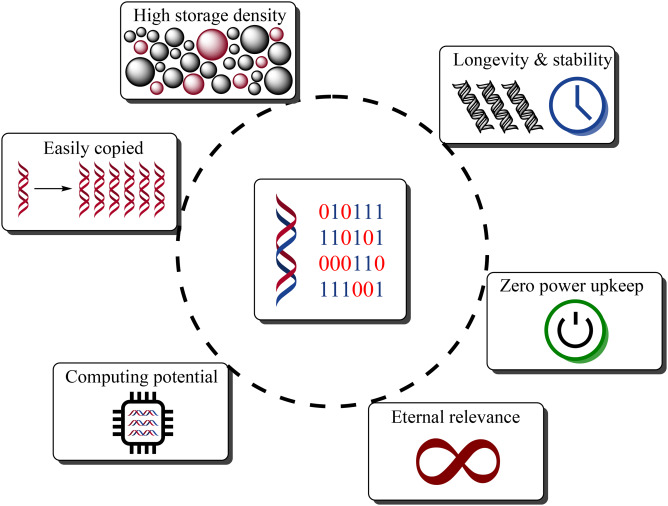
여섯 성질 중 다섯은 PART B의 "DNA 구조와 기능"에서 물리적 근거가 나옴 · 연산 잠재력은 9강(random access)·13강에서 재등장
The Chemical Structure of DNA
염기 서열 + 음전하 골격 — 정보와 골격의 분리
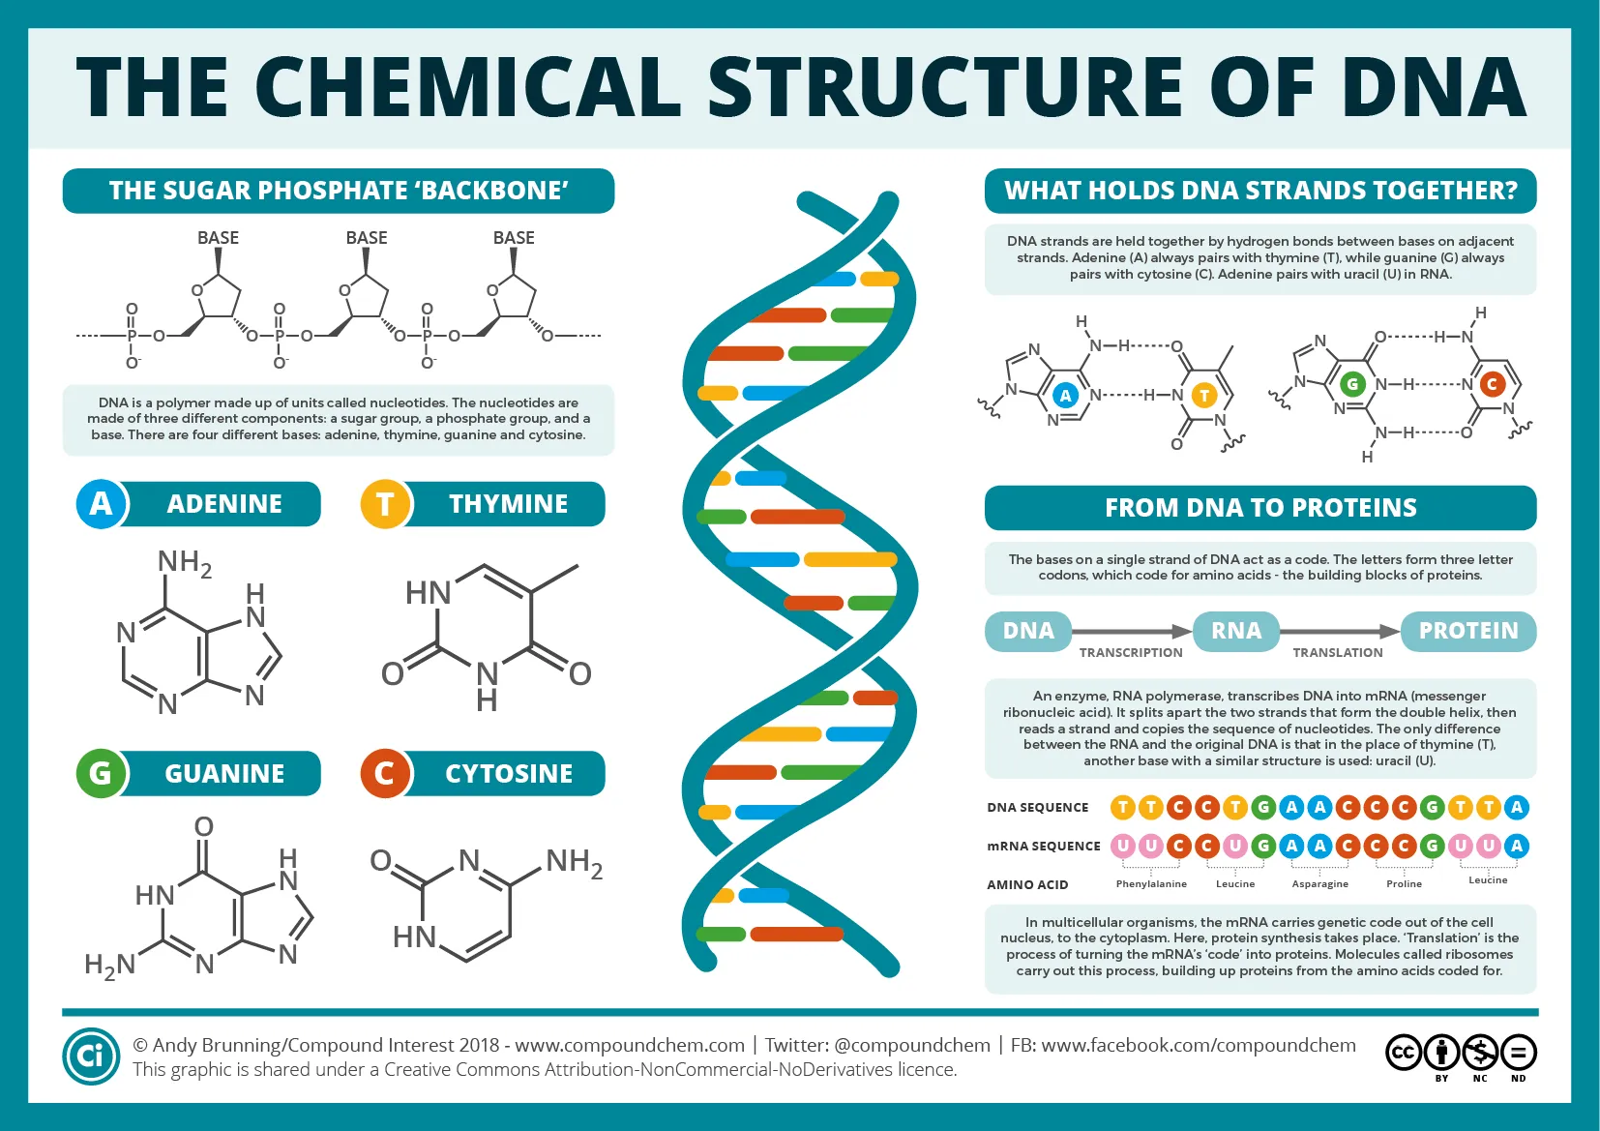
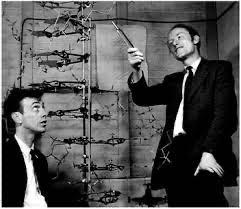
Watson & Crick, 1953
- 염기 4종 A·T·C·G의 서열 = 정보
- 당-인산 골격 = 음전하(-) · 전기영동·전기장 조작의 근거
- 연속된 염기서열로 유전 정보 저장 → 생명체 합성 (Central Dogma)
- 화학적/효소적 합성 가능 — Building block, "레고 블록"처럼
정보(염기)와 골격(당·인산)이 분리되어 있음 · 골격의 음전하 덕분에 전극 위에서 DNA를 끌어당기고(hybridization) 밀어낼(release) 수 있음 → 전기장 합성 칩
DNA 화학 구조 복습
뉴클레오티드 = 당 + 인산 + 염기
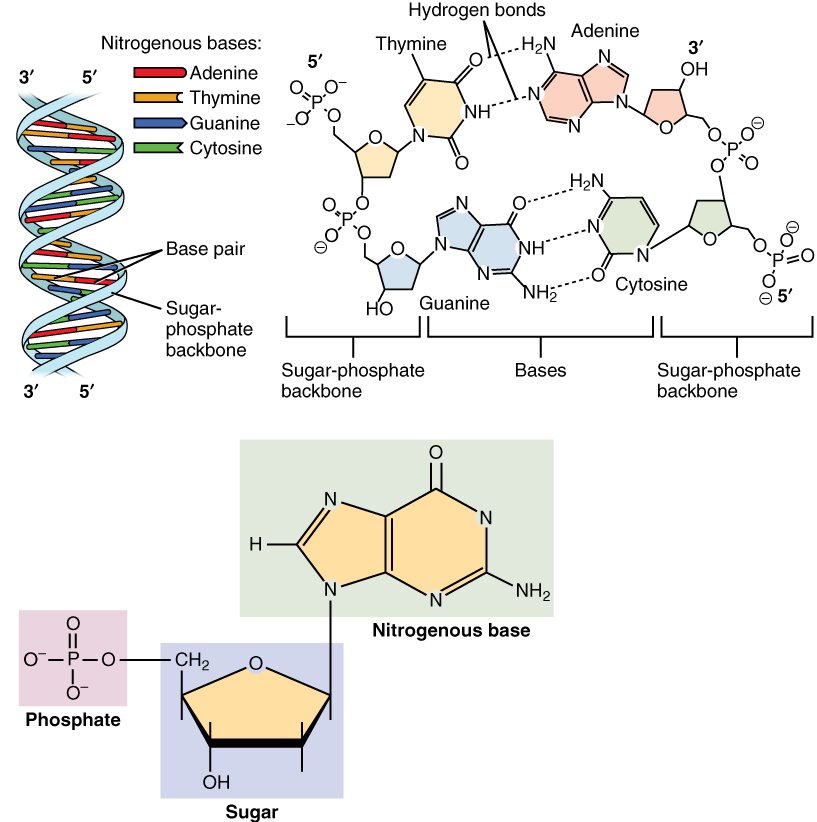
- ① 디옥시리보스 (5탄당)
- 2′ 위치에 OH 없음 — RNA와의 결정적 차이 · DNA 안정성 우위
- ② 인산기
- 음전하 → 전기영동 분리 · 전기장 조작 가능
- ③ 염기
- 퓨린(A, G) / 피리미딘(C, T) · 정보를 담는 부분
★ 방향성 — 필수 기억
포스포디에스테르 결합: 3′-OH ↔ 다음 5′-인산
→ DNA 가닥 방향: 5′ 말단 → 3′ 말단
자연의 DNA 중합효소: 5′→3′ 방향으로만 합성
화학적 포스포라미다이트 합성: 3′→5′ 방향
이 방향 차이 = 6강(화학 합성)과 7강(효소 합성)의 분기점
컴퓨터공학 전공자에게 DNA = "4진수 문자열" · 그러나 저장 한계(길이 제한·호모폴리머·합성 방향)는 모두 이 화학에서 기원
상보성 · 이중나선 · 기하학적 수치
DNA 부피 밀도의 기하학적 근거
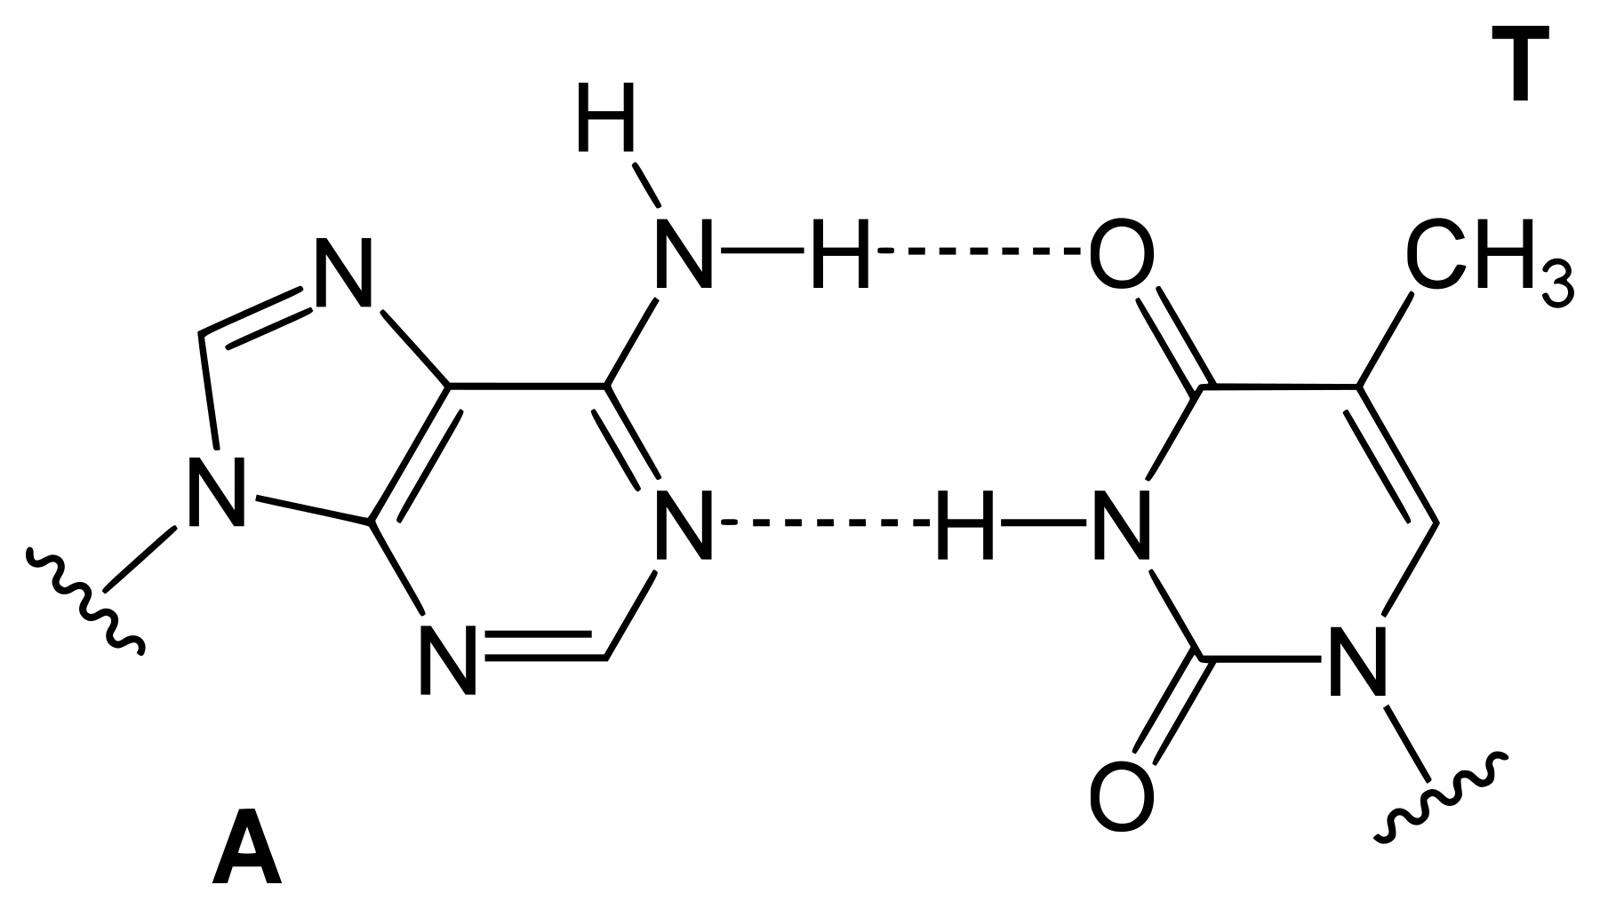
A = T
수소결합 2개
- B-form DNA 기하
- 염기쌍 간 거리 ≈ 0.34 nm · 나선 피치 ≈ 3.4 nm (약 10.5 bp) · 지름 ≈ 2 nm
- 두 가닥의 역평행성(antiparallel)
- 한 가닥이 5′→3′이면 짝은 3′→5′ · 프라이머 방향 오류 시 증폭 불가
- 밀도 계산의 출발점
- 굵기 2 nm × 길이 0.34 nm/bp에 2 bits → 비트당 부피 약 1 nm³ = "10¹⁹ bits/cm³"의 물리적 근거
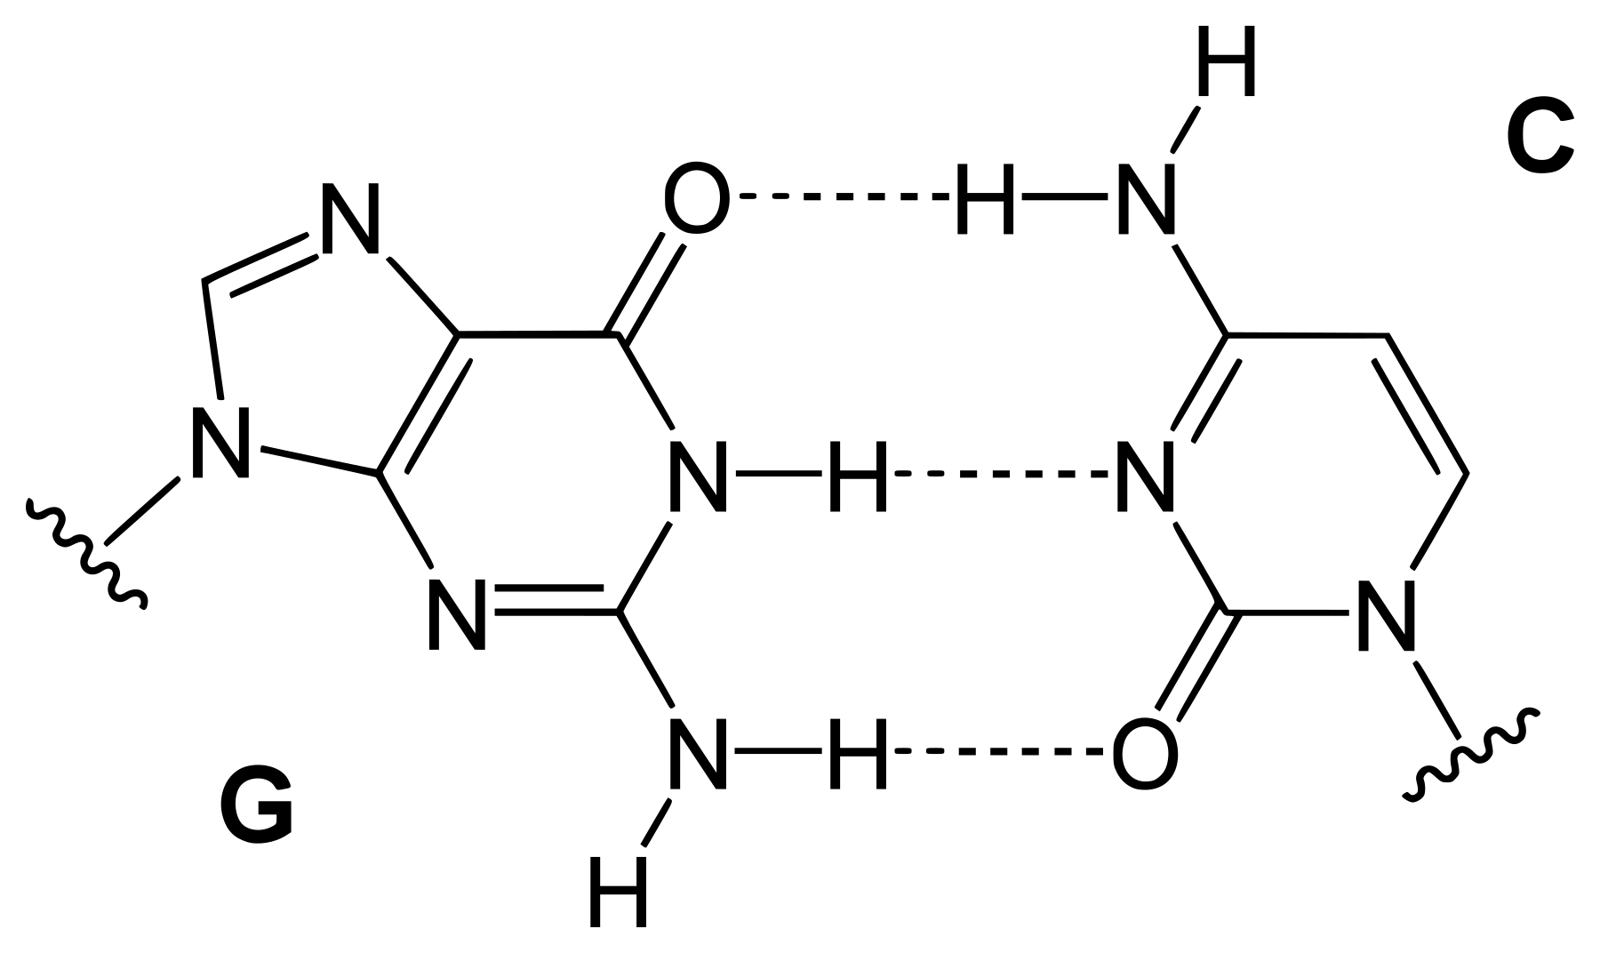
G ≡ C
수소결합 3개 → GC 함량↑ = Tm(녹는점)↑
상보성 = "짝이 정해져 있다" → 이것이 곧 다음 슬라이드의 hybridization(선택적 결합)과 PCR(복제)의 원리
Central Dogma와 "레고 블록"으로서의 DNA
생명이 DNA를 쓰는 방식 vs. 우리가 DNA를 쓰는 방식
- 생명체: DNA → RNA → 단백질 — 서열이 곧 "실행 코드"
- 저장 매체: 서열은 실행되지 않음 · 단지 "읽을 수 있는 기록"
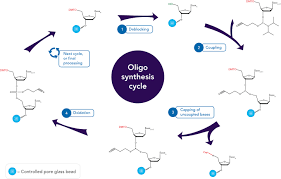
- DNA는 단량체(뉴클레오티드)를 하나씩 이어 붙이는 Building block
- 화학적 합성 — 포스포라미다이트 4단계 사이클, 3′→5′
- 효소적 합성 — TdT·중합효소·리가아제, 5′→3′
- "어떤 서열이든 주문하면 만들어 준다" = 저장 매체가 될 수 있는 전제
DNA Hybridization — 선택적 결합
DNA의 기능 ① : 짝이 맞는 서열끼리만 붙음
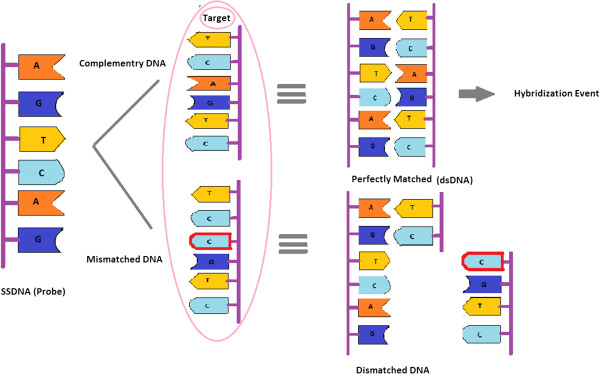
- 단일가닥 probe + 상보 서열 → 이중가닥 형성 (annealing)
- 완전 일치(perfectly matched) vs 불일치(mismatched) — 결합 안정성 차이
- 온도(Tm)·염 농도·GC 함량이 결합 강도 결정
- 저장 시스템에서의 쓰임
- 프라이머가 목표 파일 서열에만 결합 → random access (9강)
- 마이크로어레이·전극 칩 위 서열 포획 → 전기장 hybridization 합성 (파이오니어 핵심 기술)
- DNA 컴퓨팅·DB 검색 — hybridization 자체가 "비교 연산"
hybridization = 분자 수준의 "검색 연산" · 수백만 종 서열이 섞인 한 방울에서 원하는 것만 골라내는 유일한 물리적 수단
PCR — 복제 비용 0
DNA의 기능 ② : 프라이머 결합으로 유도하는 지수 증폭
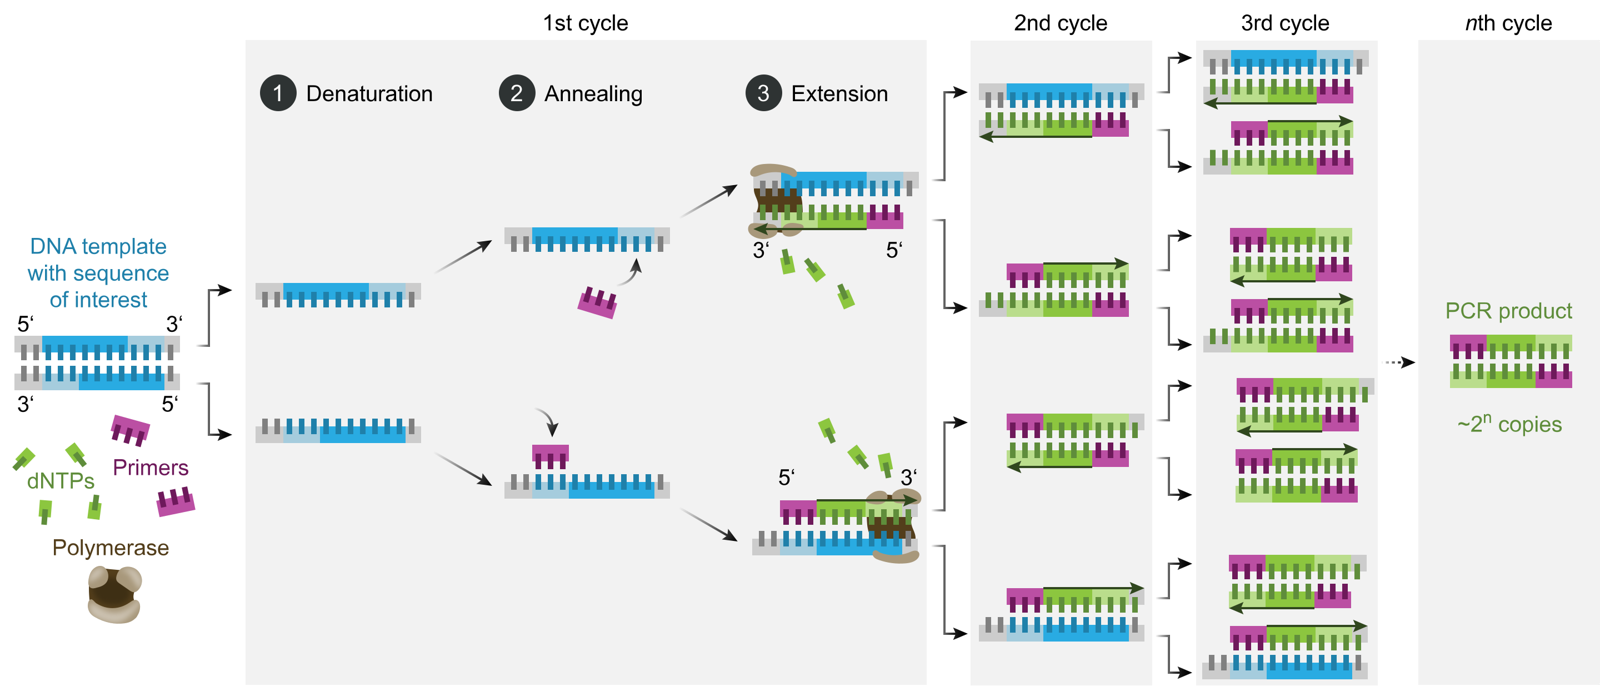
- 3단계 사이클: 변성(95 °C) → 결합(annealing, 50~65 °C) → 신장(72 °C)
- 사이클마다 2배 → 30 사이클이면 2³⁰ ≈ 10⁹배
- 프라이머 = 시작점 지정 · 앞뒤 20 nt 서열이 "파일 주소" 역할
- 저장 관점의 의미
- 읽기 전 증폭 → 시퀀싱에 필요한 양 확보
- 사본 만들기 ≈ 무료 · 백업·배포가 물리적으로 쉬움
- 대신 편향(bias)·오류 누적 → 반복 읽기의 한계 (PART A 한계표)
1 fg(10⁻¹⁵ g)의 DNA를 30 사이클 증폭하면 이론상 약 1 µg · "한 방울"에서 "시퀀서에 넣을 양"으로 — 이것이 파괴적 읽기를 견디는 이유
DNA 데이터 저장의 5단계
과목 전체의 핵심 도식 — Encoding → Synthesis → Storage → Sequencing → Decoding
+ 인덱스·프라이머·ECC
3·4·5강
화학적 / 효소적
6·7강
캡슐·건조·저온 / PCR 검색
8·9강
Illumina / ONT / PacBio
10강
→ ECC 복호 → 파일
11~13강
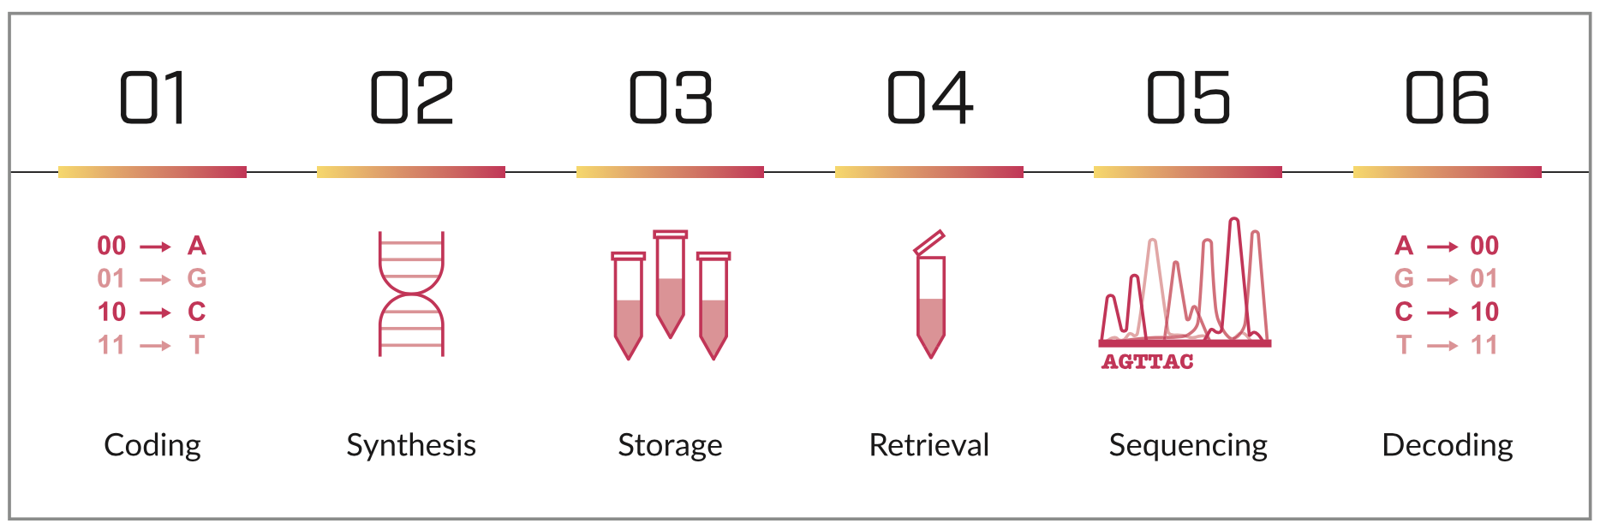
- 올리고 길이 100~200 mer (nt) 단위로 쪼개서 저장
- Forward read + Reverse read 양방향 판독으로 오류 상쇄
- 디지털 파일 → 복원 파일: 원본 해시 일치 = 성공
- 남은 12주 = 이 다섯 칸의 확대 학습
실제 시스템 구성
Xin Song et al., ACS Nano (2019) — 7단계 상세 워크플로
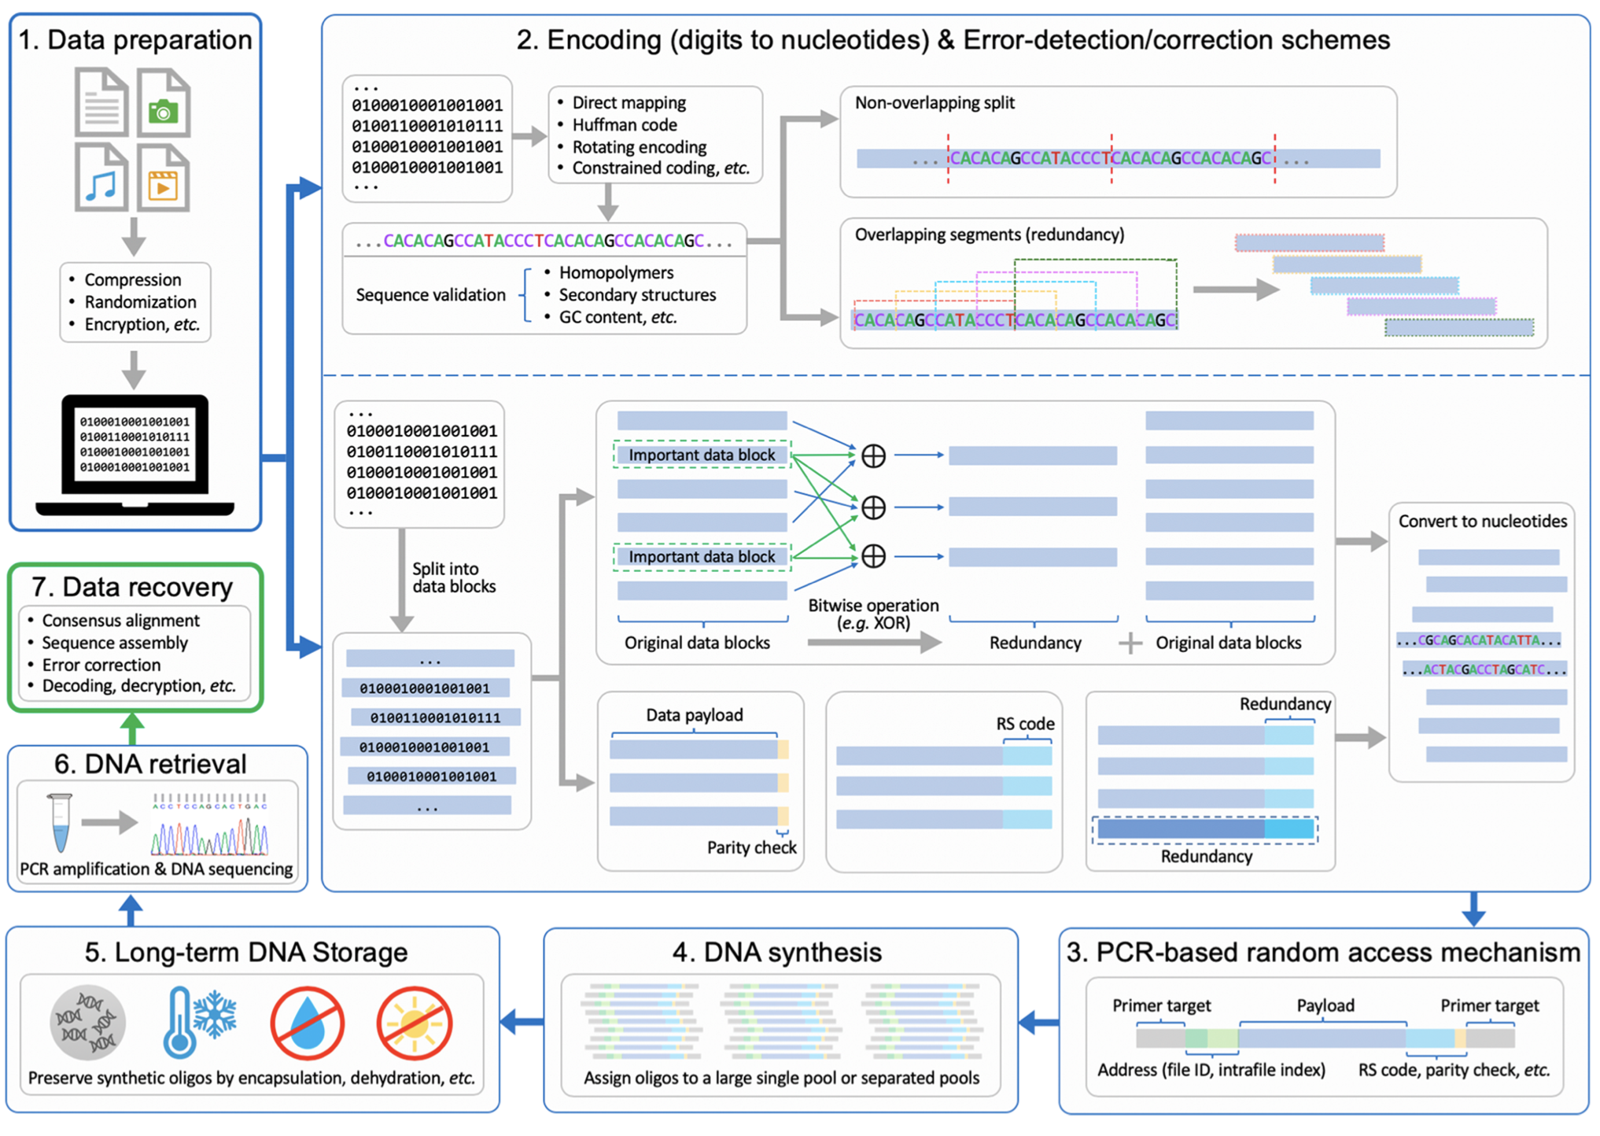
- 읽는 순서
- 1 데이터 준비 → 2 인코딩·ECC → 3 PCR random access 설계
- 4 DNA 합성 → 5 장기 보존 → 6 DNA 회수 → 7 데이터 복원
- 2번 박스의 XOR·RS·parity = 4강
- 3번 박스의 primer/address = 9강
- 앞 장의 5단계 개념도가 실제 논문에서 그려지는 방식
Xin Song et al., "Advances and Prospects of DNA Data Storage", ACS Nano (2019) — 이 강의 표 두 개의 출처 · 선택 읽기 목록
예시 — 3차원 파일을 DNA에 담기
파이오니어 과제의 "3D DNA Ink Data" 인코딩 구조
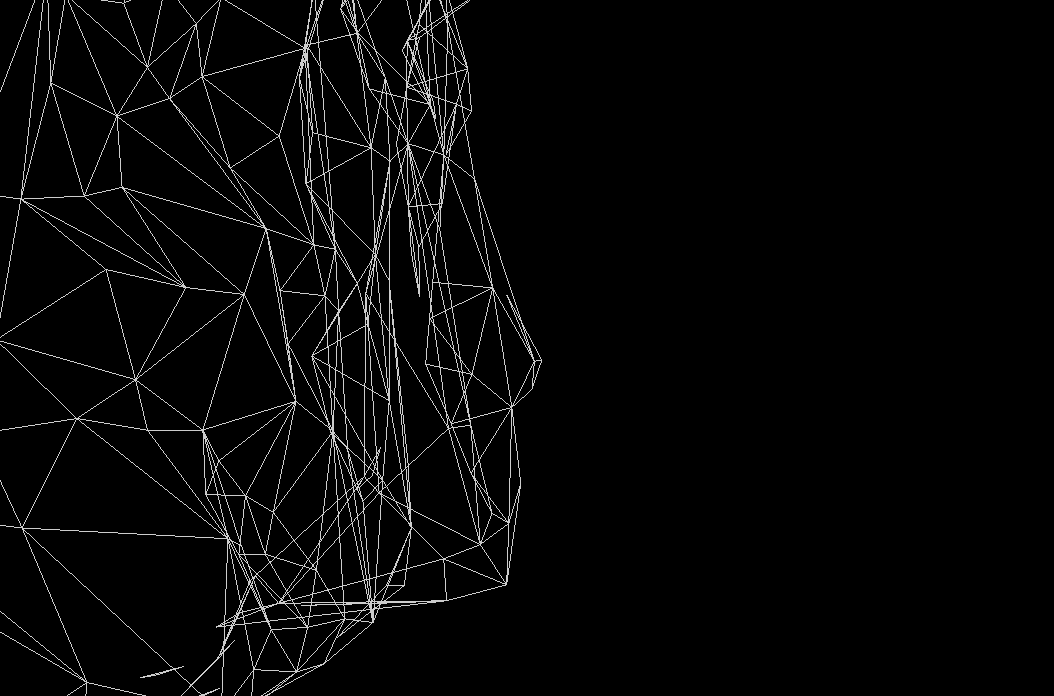
3D 메시 = 점(Points) + 연결(Connectivity)
(float)
- 디지털 파일이 "무엇이든" 결국 바이트 열 — 좌표·연결 리스트도 바이트로 직렬화 후 인코딩
- XOR로 두 올리고를 섞어 저장 → 하나가 사라져도 복원 (RAID-6 방식, 4강)
- Index Recovery Decoding — 인덱스가 깨지면 파일 ID·연결 정보로 되찾음
- 오늘은 "이런 구조로 쪼개 넣는다"만 이해 · 3주차부터 직접 인코딩 실습
2주차 강의의 이 예제 파일이 3주차(인코딩)·4강(ECC)·11강(디코딩) 실습에서 계속 등장 · 같은 파일로 전체 파이프라인을 완주하는 것이 학기 목표
DNA 데이터 저장 마일스톤 타임라인
1953 → 2024
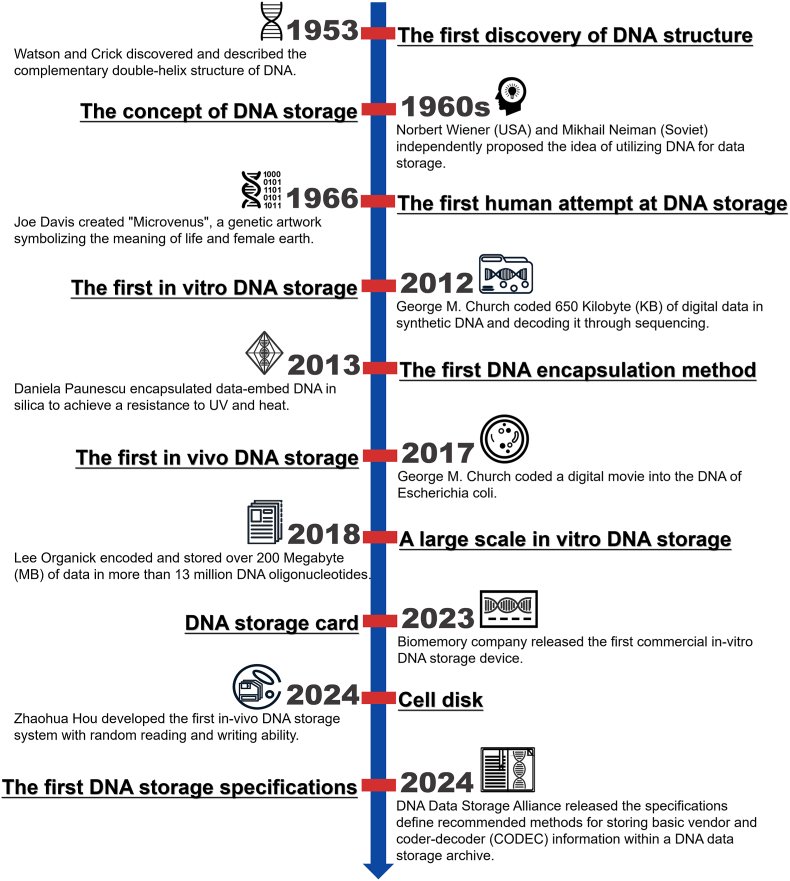
- 수업에서 강조할 4개 지점
- ① 2012 Church — "책 한 권" 규모 첫 달성
- ② 2013 Grass/Paunescu — 실리카 캡슐화로 "보존"의 공학 문제화
- ③ 2018 Organick — 200 MB + random access · 시스템의 시대
- ④ 2024 DNA Data Storage Alliance 스펙 — 산업 표준의 시작
"1966 — Joe Davis, Microvenus"는 오류 · 실제는 1988년 · 출판된 그림도 검증하라
숫자로 보는 실제 구현
Xin Song et al., ACS Nano (2019) — Table 2
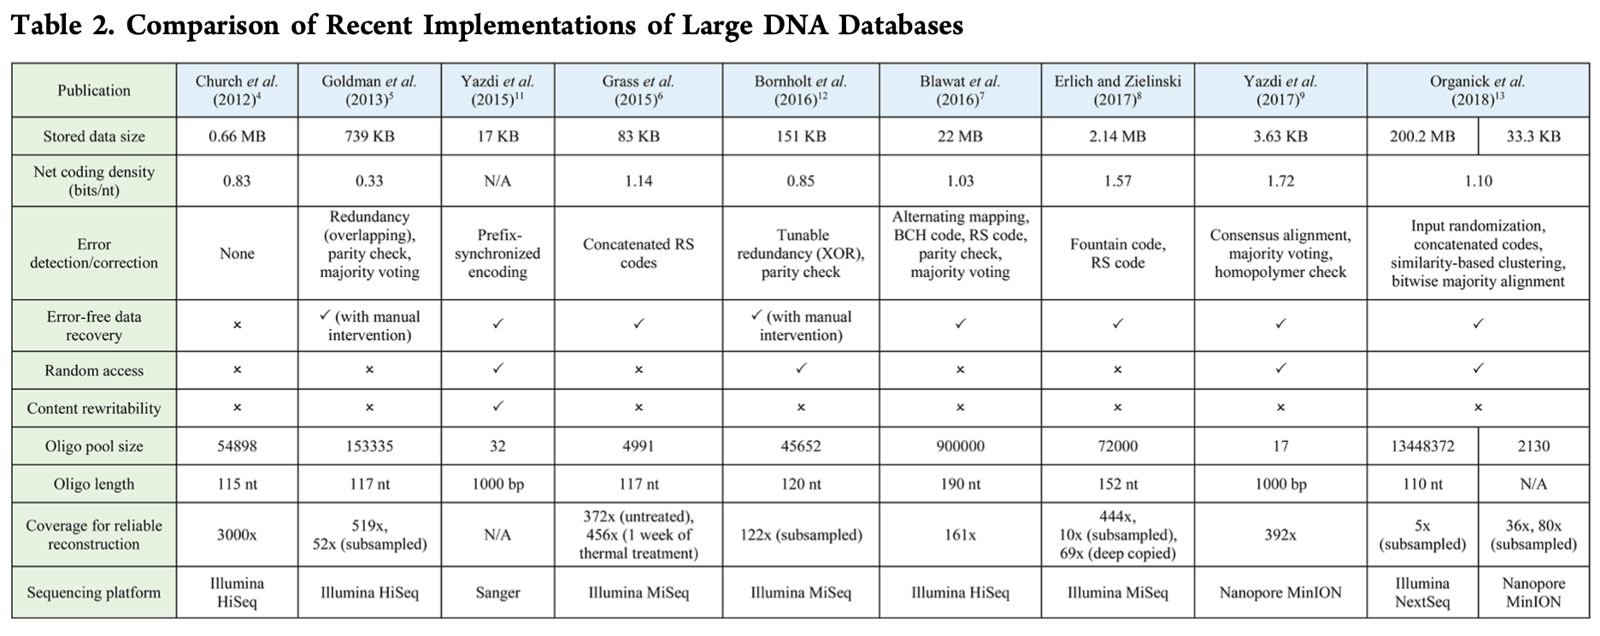
★ "밀도"의 정의가 다르다
앞에서 Goldman 1.58, Grass 1.78, Erlich 1.98 bits/nt
이 표의 Net coding density는 0.33, 1.14, 1.57
앞의 값 = 코딩 규칙 자체의 이론 밀도 (coding potential)
이 표 = 프라이머·인덱스·중복까지 포함한 실효 밀도 (net)
Coverage 행: Church 3000× → Organick 5× · 이것이 비용을 결정
논문의 숫자를 읽을 때 어느 정의인지 확인하지 않으면 분야 전체가 과장되어 보임 · 파이오니어 목표 2 PB/g도 "net" 기준
합성 DNA — DNA 메모리 합성 방법
일반 유전자 합성과 동일한 화학 · 그러나 "메모리 전용 합성장치"는 아직 없음
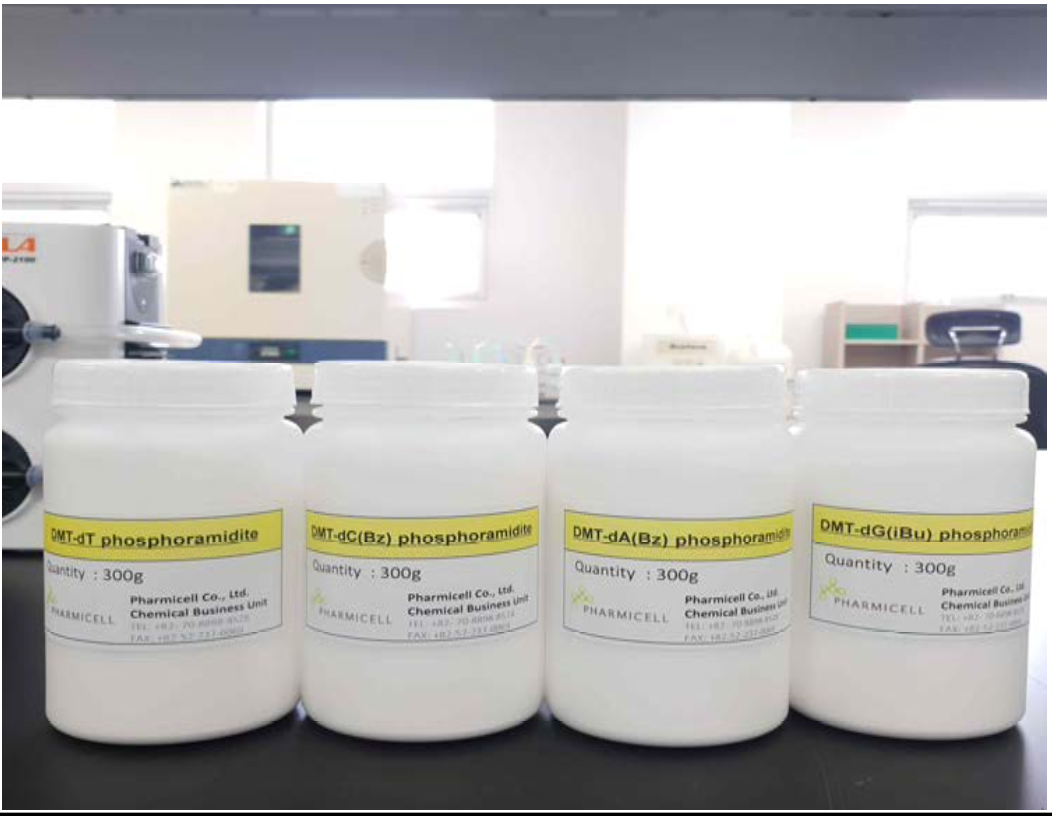
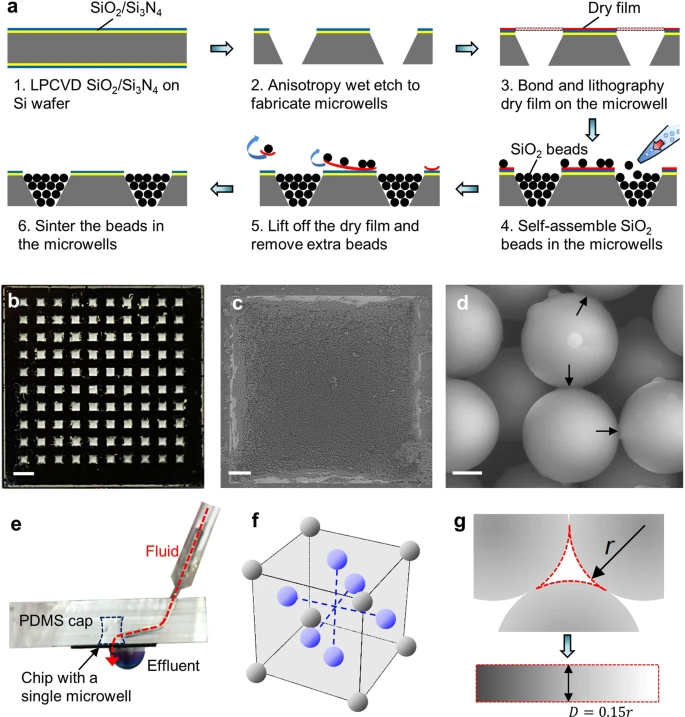
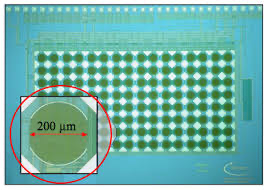
포스포라미다이트 시약 · 마이크로웰 칩 · 전극 어레이(200 µm)
- 화학적 합성 = 포스포라미다이트 4단계 사이클 (탈보호→결합→캡핑→산화)
- 독성 화합물(아세토니트릴·요오드 등) 사용 · 컬럼당 단일 서열
- 플레이트(96/384 well)로 물리적 분리 → 복수 서열 병렬 합성
- 마이크로 디바이스로 병렬화
- DMD(디지털 마이크로미러) 광화학 · CMOS 전기화학 · Microwell 잉크젯
- Twist·Agilent·CustomArray 등 — 한 칩에 수만~수백만 종
- DNA 메모리용 합성장치의 부재
- 유전자 합성기는 "정확한 긴 서열 소량" 최적 · 메모리는 "짧은 서열 수백만 종 초저가" 필요
- → 파이오니어 과제: 전기장 합성 칩 + 효소 합성 + 벤치탑 합성기
합성 비용과 속도 — 상용화의 진짜 관문
DNA 메모리 합성 비용 · 속도 · 목표
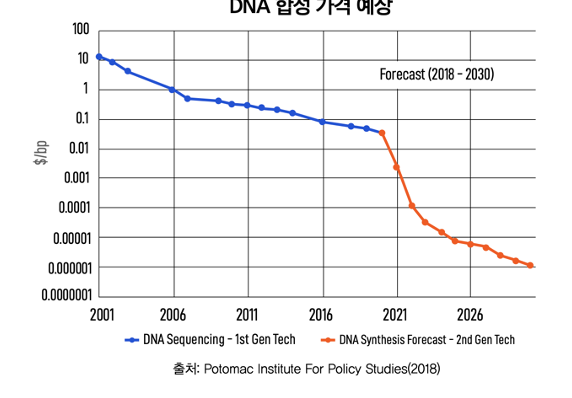
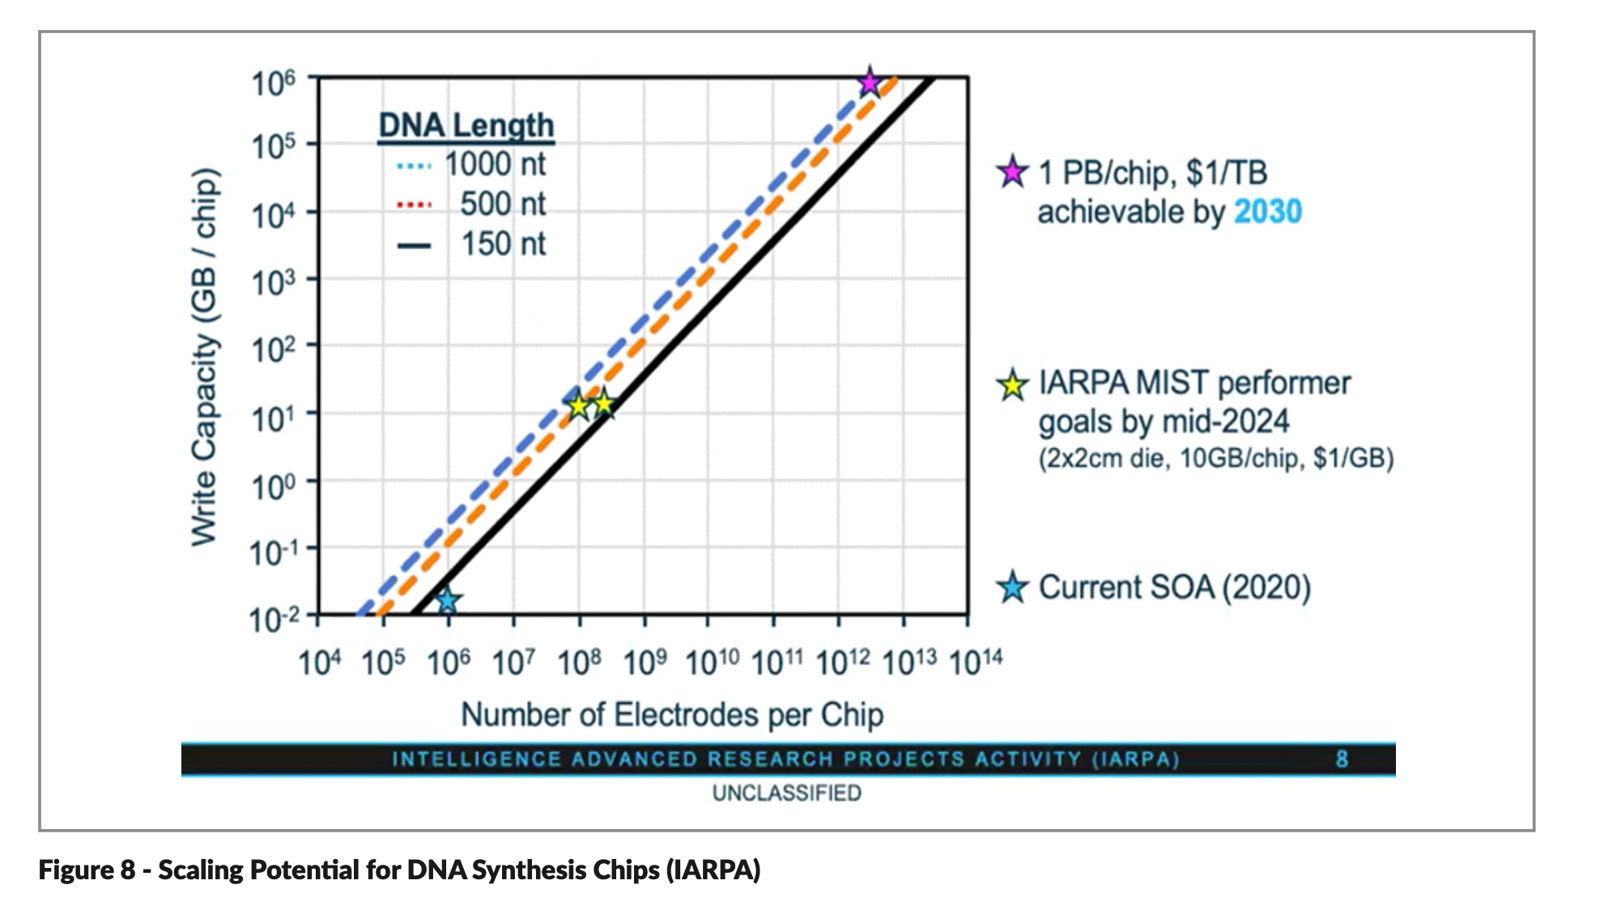
비용
- 염기 1개 합성: 15달러(2001) → 7센트(2017) → 0.5센트 목표(2027)
- 1 MB당 약 3,500달러(현재) → 2,100달러 전망 · HDD $0.02/GB와 6~8자릿수 차이
- 파이오니어 목표: 500원/GB (합성 기준) · IARPA MIST: 1 PB/chip, $1/TB (2030)
속도
- 화합물 기반 합성: 주문생산 방식 1일~3주
- 효소 기반 합성: 이론상 < 100 µs/bit · Catalog 1 TB/24 h (2019)
- 데이터 "복사"는 PCR 기반 합성으로 — 쓰기와 복사를 분리
왜 비용이 안 떨어지는가
- 시퀀싱 비용은 20년간 10⁶배 하락 · 합성 비용은 10²배에 그침 (왼쪽 위 그래프)
- 합성은 "한 분자씩 화학 반응" · 반도체처럼 병렬화·소형화해야 곡선이 꺾임
읽기(시퀀싱)는 이미 싸졌고, 쓰기(합성)가 병목 · 그래서 이 분야의 하드웨어 연구 = 거의 전부 "합성 장치"
효소 기반 합성의 대두
Terminal deoxynucleotidyl Transferase (TdT) — 물 속에서, 상온에서, 5′→3′로
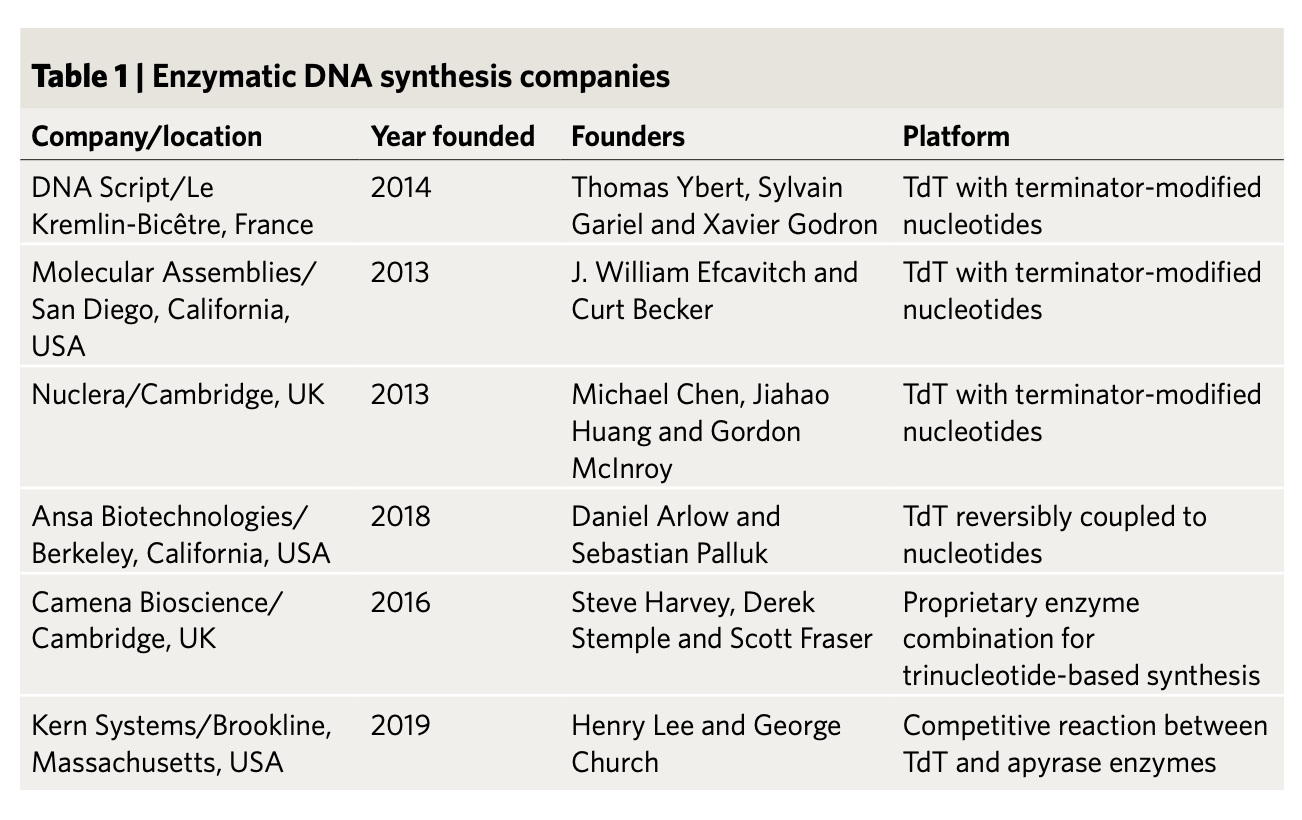
Nature Biotechnology (2018) Table 1 — 효소적 DNA 합성 기업
- TdT = 주형 없이 3′ 말단에 뉴클레오티드를 붙이는 효소
- 보호기가 달린 dNTP(예: dNTP-N₃)를 한 번에 하나씩 → 탈보호 → 반복
- 화학 합성 대비 장점
- 독성 용매 불필요 · 수용액·상온 · 긴 서열(1 kb 이상) 가능성
- 전극·칩 위에서 직접 합성 → 데이터 "쓰기 헤드"로 적합
- 기업: DNA Script · Molecular Assemblies · Nuclera · Ansa · Camena · Kern
- 파이오니어 과제: Klenow → T4 Ligase → TdT 단계별 도입
7강에서 TdT 반응 메커니즘·변형 dNTP·반응 사이클을 상세히 · 오늘은 "왜 효소인가"만 기억
읽기 — 염기서열 분석과 데이터 복원
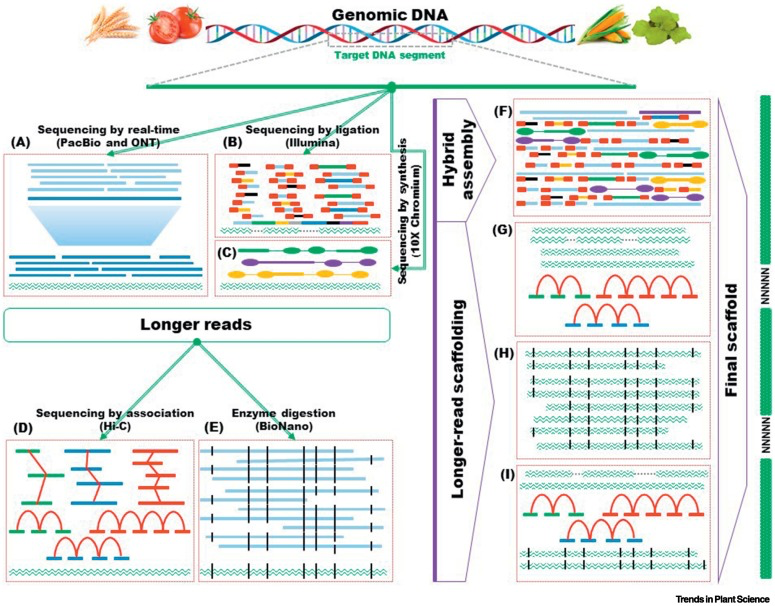
DNA 메모리 Reading: 시퀀싱 플랫폼 + 정렬·복원 알고리즘
| 플랫폼 | read 길이 | 정확도 | 특징 |
|---|---|---|---|
| Illumina (SBS) | 150~300 nt | ~99.9% | 대량 병렬 · 짧은 read · 표준 |
| Oxford Nanopore | 수 kb~ | ~95~99% | 실시간 · 휴대형 · indel 많음 |
| PacBio (HiFi) | 10~20 kb | ~99.9% | 긴 read · 고비용 |
| BGI / 기타 | 100~150 nt | ~99.9% | 저가 대안 |
- De novo 시퀀싱 기반: 참조 없이 read를 모아 consensus → 느림(> 12 h)
- DB 기반 정렬(in silico): 인덱스·프라이머 정보를 참조로 정렬 → 30분 → 실시간 목표
- 파이오니어: Primer/Index sorting → 10× coverage 완전 복구 → 0.3 Gbps 파일 2분 미만
시퀀싱은 10강, 디코딩·k-mer·딥러닝 복원은 11~13강 · 읽기는 이미 "싸고 빠른" 쪽 — 문제는 쓰기
DNA Data Storage 시장
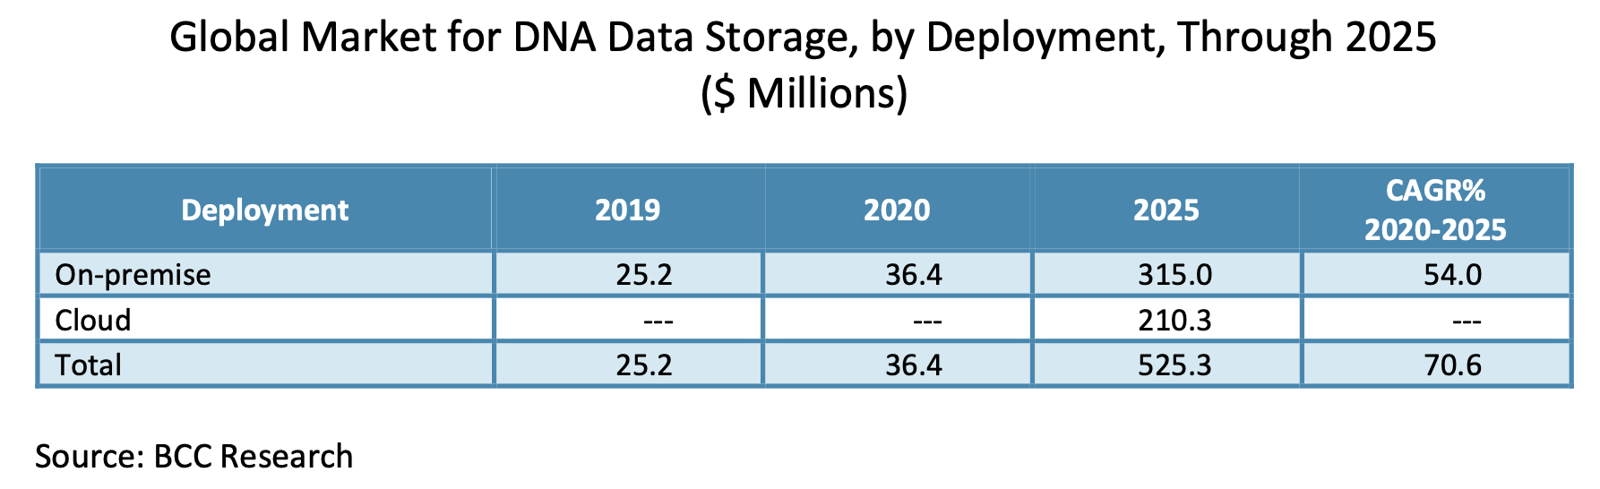
Cold data 시장에서 출발 · 연평균 70% 성장 전망
- Cold data 시장
- 자주 접근하지 않는 중요 데이터 · 자기테이프·HDD가 주력
- DNA Data Storage Alliance(2020~) — 콜드 데이터 시장을 첫 목표로 표준화
- 글로벌 시장 전망 (BCC Research)
- 연평균 성장률 70.6% · 온사이트(on-premise) 54.0%
- 정부·국방·은행·보험·미디어 아카이브 시장 형성 중
- Gartner 저장 피라미드 — 맨 아래 "Deep archive" 층이 DNA의 자리
- 파이오니어 최종 목표 — 벤치탑 DNA 스토리지(Writing/Reading 워크스테이션)
시장 예측은 2020년 자료 · 이후 Catalog 소멸(2026)·Twist 분사(2025) 등 재편 진행 중 → "회사별 DNA 저장·합성 방식 정리" 페이지 참고