MOLECULAR INFORMATION STORAGE SYSTEM

분자정보 저장 시스템

제1강

정보 저장의 역사와 메모리 계층 | DNA 데이터 저장 프로세스와 역사

송영준 Youngjun Song, Ph.D. · 인천대학교

← → 이동S 목차R 읽기 모드F 전체화면
학습목표

저장매채, DNA 저장 워크플로6가지

  • 저장 매체의 속도·밀도·수명·비용·에너지 5축 비교
  • 메모리 계층 존재 이유의 물리적 설명
  • 콜드 데이터·매체 마이그레이션 문제 정의
  • DNA 저장 6단계 워크플로의 단계별 설명
  • 각 단계의 입력·출력 및 주요 오류 원인 구분
  • DNA 저장 성능의 밀도·회수율·속도·비용 기반 평가
분자정보 저장 시스템

DNA는 DRAM·SSD를 대체하지 않음 · 목표 지점 = 메모리 계층 최하단, LTO 테이프보다 아래의 "동결 아카이브(frozen archive)" 계층

Contents

1강 = 정보와 저장매체/ 2강 = DNA

PART 1

정보 저장의 역사

PART 2

데이터 폭증과 콜드 데이터

PART 3

메모리 계층 구조

PART 4

왜 DNA인가

PART 5

DNA 구조와 정보 표현

PART 6

저장 프로세스 6단계

PART 7

DNA 저장의 역사

제1강 · 정보저장의 역사와 메모리 계측구조
제2강 · DNA 저장 매체
PART 1

정보 저장의 역사

History of Information Storage

  • 인류는 무엇에 기록해 왔는가
  • 매체마다 무엇을 얻고 무엇을 잃었는가
  • 디지털 저장은 무엇을 폭발시켰는가

저장기술이란

저장 기술의 "발전"이란 정확히 무엇을 개선한 것인가?

점토판 (B.C. 3000)

3,000년

지금도 판독 가능 · 니네베 도서관 화재 당시
오히려 구워져 더 단단해짐

3.5인치 플로피디스크 (1980s)

30년

판독 장치 확보가 더 어려움
매체는 남아도 판독기는 사라짐

질문

밀도·속도·비용은 지속적으로 개선됨 · 그런데 수명과 "읽을 수 있음"은? 저장 기술의 역사 = 이 둘을 맞바꿔 온 역사

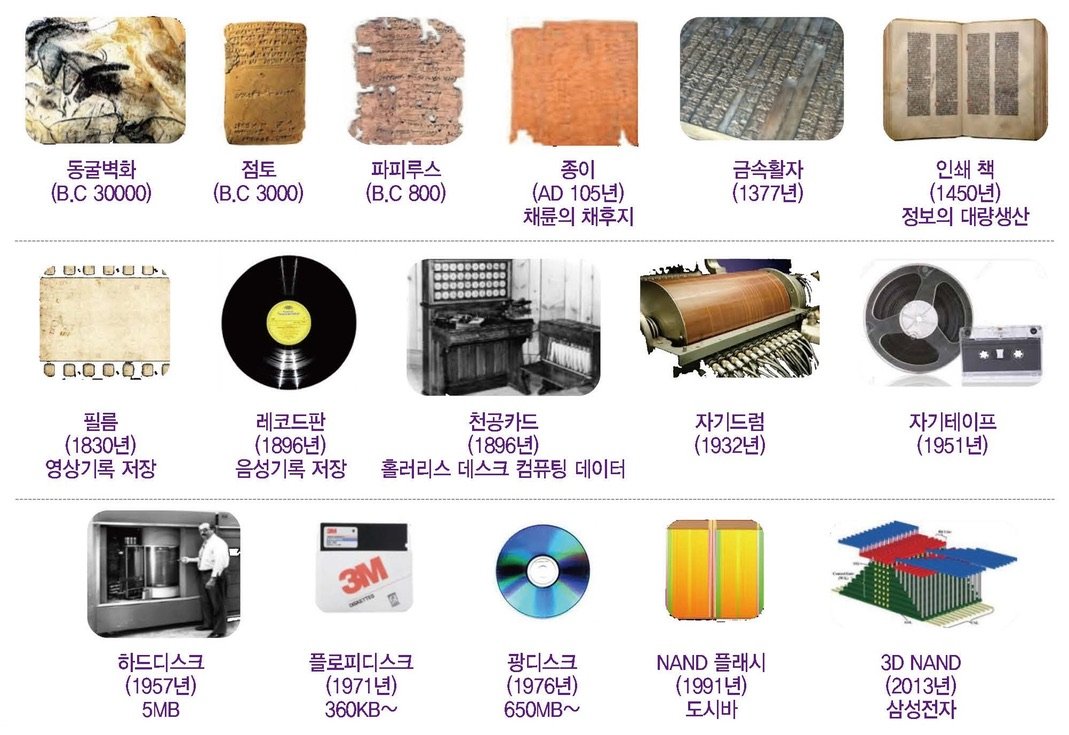
기록 매체의 역사

동굴벽화에서 3D NAND까지

동굴벽화에서 3D NAND까지 기록 매체의 역사 그림
역사적 주목

1377년 금속활자 = 직지심체요절 · 세계 최초의 금속활자 인쇄본이 한국 기록 매체사에 존재함

물질에 새기던 시대

점토판 · 파피루스 · 종이 — 그리고 교환관계의 시작

  • 점토판 (B.C. 3000) — 밀도는 최악, 수명은 최고
    • 젖은 점토에 쐐기문자 각인 후 소성·경화
    • 화재가 오히려 매체를 강화한 유일한 사례
  • 파피루스·양피지 → 종이 (A.D. 105 채륜)
    • 기록 비용 급락 → 정보 대량 생산 가능
    • 대신 물·불·곰팡이·산화에 취약
  • 인쇄술 (1377 금속활자 / 1450 구텐베르크)
    • "복제 비용"의 첫 0 근접

반복되는 교환관계

밀도 ↑ 편의성 ↑
내구성 ↓ 수명 ↓

이 교환은 자기테이프·플래시·DNA bits/nt 설계에서 동일하게 반복됨

한국의 아카이브 설계

팔만대장경 — 13세기의 장기보존 엔지니어링

  • 8만여 장의 목판, 약 5,200만 자 (1251년 완성)
  • 저비용 매체에 의도적 내구성 설계
    • 자작나무 판재를 소금물에 삶아 뒤틀림·벌레 방지
    • 옻칠로 표면을 밀봉해 습기·산화 차단
    • 장경판전: 통풍·습도 자연조절 구조 보관
  • 직지심체요절 (1377) — 현존 최고(最古) 금속활자본

오늘의 DNA 보존과 같은 문제의식

목판 → 소금물 삶기 → 옻칠 → 통풍 보관

↓

DNA → 실리카 캡슐화 → 건조 → 저온 보관

매체 간 700년 차이에도 열화 요인(수분·산소·온도·생물) 차단 전략은 동일함

수업의 응용 주제

문화유산 DNA 보존 연구(직지·팔만대장경 DNA Data Ink) 실제 진행 중 · 15주차 응용 파트에서 재논의

디지털 저장의 폭발

70년 만에 부피당 밀도 10⁸배

3.75 MBIBM 305 RAMAC (1956)
24인치 디스크 50장 · 약 1톤
→
1 TBmicroSD 카드 (현재)
손톱 크기 · 약 0.5 g
=
10⁸배부피당 밀도 향상
  • 무엇이 이 폭발을 만들었는가 — 세 축
    • 자기 기록의 미세화: 수직자기기록(PMR) → 열보조자기기록(HAMR)
    • 광학 기록의 파장 단축: CD 780 nm → DVD 650 nm → Blu-ray 405 nm
    • 반도체 미세공정과 3차원 적층: 평면 NAND → V-NAND (200단 이상)
그런데

밀도 10⁸배 향상 · 그런데 수명은? RAMAC 자기디스크와 오늘의 SSD 모두 10년 안팎 · 밀도만 개선됨

비휘발성 저장 매체 비교

Xin Song et al., ACS Nano (2019) — Table 1
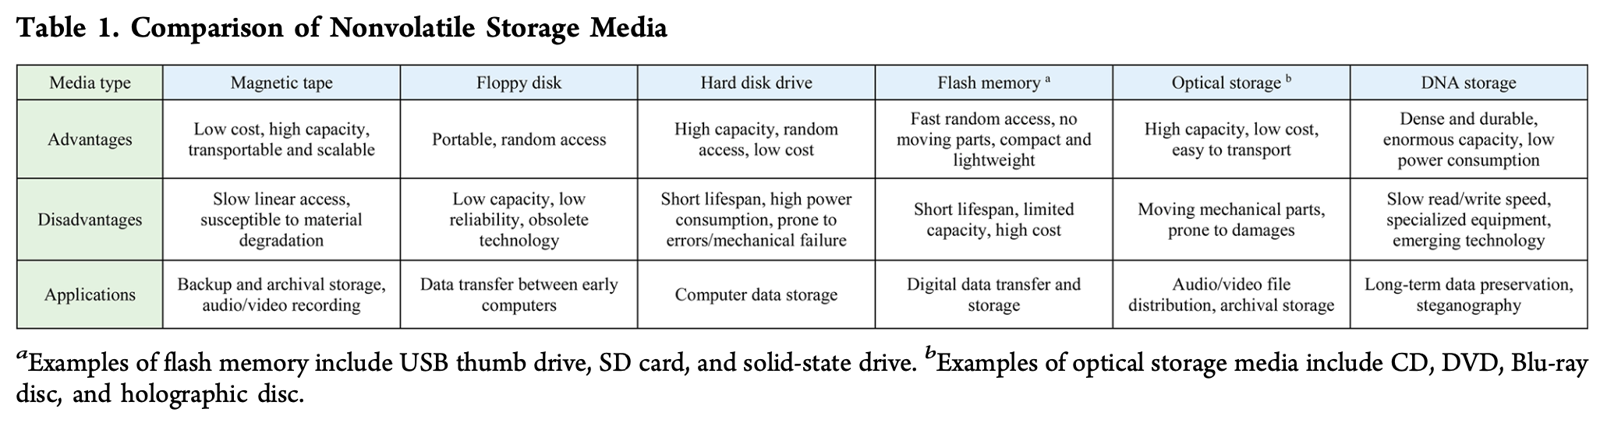
Table 1. Comparison of Nonvolatile Storage Media
DNA

장점 = "Dense and durable, enormous capacity, low power consumption",
단점 = "Slow read/write speed, specialized equipment, emerging technology"
밀도·수명·에너지 우위, 속도·비용 열세 · 강의 전반에 반복되는 구도

PART 2

데이터 폭증과
콜드 데이터

The Cold Data Problem

  • 데이터는 얼마나 빨리 늘어나는가
  • 생성된 데이터는 모두 저장되는가
  • 거의 읽지 않는 데이터를 어디에 둘 것인가

데이터스피어 — ZB의 세계

전 세계가 매년 생성·복제하는 데이터의 총량

221+ ZB연간 데이터 생성·복제량
(2025년 전후, IDC Global DataSphere 추정)
10²¹ byte1 ZB = 1조 GB
= 1,000 EB = 10억 TB
수백 ZB2020년대 후반 전망
  • 결정적 사실: 생성 데이터 대부분은 저장되지 못함
    • 저장 매체 생산 능력(반도체 팹·HDD 공장·테이프 라인)은 생성 속도 추월 불가
    • 이미 "무엇을 버릴 것인가"를 강제로 선택하는 시대
    • 생성량은 지수 증가 / 매체 생산은 공장 증설 속도로만 증가
데이터 증가량

"IDC (2022년 대비 2배 이상 증가, 연평균 성장률 약 21.2%
출처: IDC (International Data Corporation)

보고서 원제: Worldwide IDC Global DataSphere Forecast, 2022–2026: Enterprise Organizations Driving Most of the Data Growth (Doc #US49018922)

아날로그에서 디지털로

2002년 — 인류가 디지털에 더 많이 저장하기 시작한 해
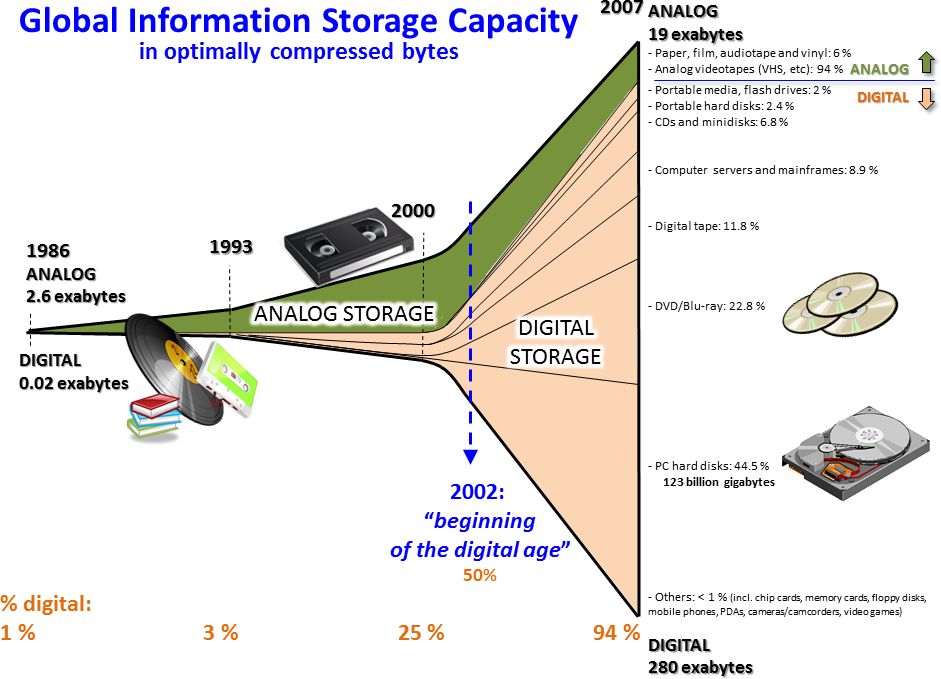
Global Information Storage Capacity in optimally compressed bytes, 1986–2007
  • 1986년
    • 아날로그 2.6 EB / 디지털 0.02 EB — 디지털 비중 1%
  • 2002년 — "디지털 시대의 시작"
    • 디지털 비중 첫 50% 초과
  • 2007년
    • 아날로그 19 EB / 디지털 280 EB — 디지털 94%
    • PC 하드디스크만 44.5% (1,230억 GB)
  • 무엇이 바뀌었는가
    • 저장의 물리적 형태 통일 · 종이·필름·테이프 모두 "비트"로 변환
    • 단일 매체에 모든 정보 저장 가능 → DNA도 그 후보

출처: Hilbert & López, Science (2011), "The World’s Technological Capacity to Store, Communicate, and Compute Information" · CC BY-SA 3.0

데이터의 온도

접근 빈도로 나눈 네 계층

계층접근 빈도대표 예시요구 지연시간적합 매체
Hot초 단위 · 상시실행 중 DB, 캐시ns ~ μsSRAM / DRAM
Warm일 · 주 단위최근 로그·활성 데이터msSSD / HDD
Cold월 · 년 단위백업·규제 보관 자료초 ~ 시간HDD / 광디스크
Frozen거의 없음법정 보존·과학 원본·문화유산시간 ~ 일LTO 테이프 / ★DNA
규모

기업 데이터 상당 부분(추정 60~80%) = 한 번 쓰고 거의 읽지 않는 콜드 데이터 · 전체 저장 비용 대부분이 "거의 안 읽는 것"에 투입됨

DNA가 노리는 자리

DNA는 Hot·Warm 계층이 아님 · 최하단 Frozen, 그중 LTO보다 아래 겨냥 · 속도 포기 대신 밀도·수명·에너지 확보

테이프 아카이브의 진짜 비용

100년 보존 = 매체 마이그레이션 8~10회

↓ 각 지점마다 새 세대 매체로 전체 재기록 필요

0년
10년
20년
30년
…
90년
100년
  • 매번 발생하는 비용
    • 새 드라이브·새 카트리지 구매, 데이터 전송 시간, 검증 작업, 인건비
    • 전송 중 비트 오류·매체 불량에 따른 소실 위험 누적
  • 그리고 더 근본적인 위험 — 포맷 진부화
    • LTO 드라이브는 보통 2~3세대까지만 하위 호환
    • "그 포맷을 읽을 장치가 아직 존재하는가"가 100년 뒤에도 참이어야 함
DNA의 목표 시장

DNA의 경쟁 상대 = GB당 가격이 아닌 "100년간 총소유비용(TCO)"

PART 3

메모리 계층 구조

The Memory Hierarchy

  • 왜 하나의 매체로 끝내지 못하는가
  • 각 계층은 어떤 물리 원리로 동작하는가
  • NAND의 SLC→QLC가 DNA에 주는 교훈

계층이 존재하는 이유

"빠르고 크고 싸고 안 지워지는" 물질의 부재

지연시간
용량
빠름
작음
비쌈
느림
큼 · 쌈
초장수명
레지스터
~1 ns
수 KB
SRAM 캐시
1–20 ns
수 MB
DRAM
~80–100 ns
수 GB–TB
NAND SSD
수십 μs
TB급
HDD
수 ms
10–30 TB
광디스크 / LTO 테이프
초–시간
수십 TB/카트리지
★ DNA
시간–일
이론상 EB/g

위쪽 계층 — SRAM과 DRAM

전기 공급이 필요한 기억(휘발성)

SRAM

6개 트랜지스터 래치 = 1 bit

  • refresh 불필요 → 가장 빠름 (1–20 ns)
  • 비트당 트랜지스터 많음 → 낮은 밀도·높은 비용
  • 용도: CPU L1/L2/L3 캐시

DRAM

트랜지스터 1개 + 커패시터 1개 (1T1C)

  • 커패시터 전하 누설 → 수십 ms마다 refresh
  • 이 refresh = 데이터센터 전력의 상당 부분
  • SRAM보다 훨씬 높은 밀도 · 용도: 메인 메모리
DNA와 대비되는 지점

SRAM·DRAM은 정보 유지를 위해 "계속 에너지를 써야 한다" · DRAM은 초당 수십 회 자체 재기록
DNA는 보관 중 에너지 소비 사실상 0 · 화학적 안정성 자체가 저장 메커니즘

NAND 플래시 — 밀도와 오류율의 교환

오늘 강의에서 가장 중요한 유비(analogy)

  • 원리: 플로팅 게이트 / charge trap 층에 전자를 가둬 문턱전압(Vt) 변경
    • 전원 없이 전하 유지 → 비휘발성
방식셀당 비트전압 준위밀도오류율 / 수명
SLC1 bit2단계×1최저 오류율·최장 수명
MLC2 bits4단계×2↓
TLC3 bits8단계×3↓↓
QLC4 bits16단계×4오류율 급증·P/E 감소
PLC5 bits32단계×5실용화 난이도 매우 높음
★ DNA에서 동일하게 반복되는 구조

셀당 비트 증가 → 전압 준위 간 마진 축소 → 오류율 급증
DNA도 동일: nt당 2 bits 근접 → GC·호모폴리머 제약 위반 → 합성·시퀀싱 오류 증가
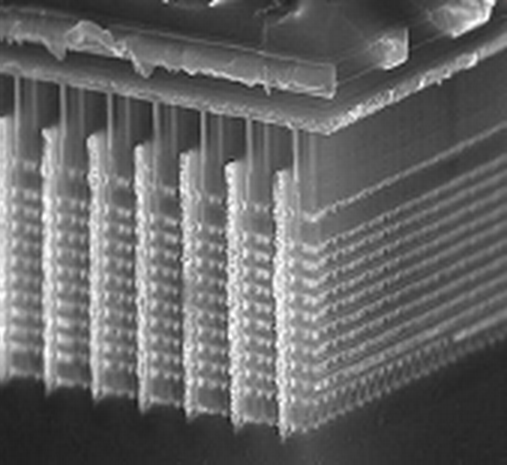
3D V-NAND 단면 전자현미경 사진

3D V-NAND 단면 (셀을 수직으로 200단 이상 적층)

아래쪽 계층 — HDD · 광디스크 · LTO 테이프

아카이브의 현실적 주력

HDD

회전 자성 원판 + 부상 헤드

  • 기계 부품 → 지연시간 ms 단위
  • 진동·충격에 취약
  • 계속 회전 → 전력 상시 소모
  • 용량당 단가는 낮은 편

LTO 테이프

아카이브의 사실상 표준

  • $/TB 가장 낮음, 보관 중 전력 0
  • 세대마다 용량 약 2배씩 증가
  • 순차 접근 → 파일 하나에 수십~수백 초
  • 드라이브 호환 2~3세대 → 마이그레이션 강제
아카이브의 딜레마

LTO 저장 자체는 거의 공짜 · 문제 = "계속 살아있게 유지하는 비용" · 10년마다 전체 재기록, 사람·장비·위험 추가
→ 한 번 쓰고 손대지 않아도 되는 매체가 있다면? DNA의 제안

매체를 평가하는 5(+2) 축

모든 논문·제품을 읽는 평가 틀

1속도latency / bandwidth
첫 바이트까지, 초당 몇 바이트
2밀도volumetric density
단위 부피·질량당 바이트
3수명retention
개입 없이 몇 년을 견디는가
4비용$/TB
매체 + 장비 + 운영(전력·냉각·인건비)
5에너지보관 중 소비 전력
기록·판독 시 에너지
6포맷 진부화 위험100년 뒤에도 읽을 장치가 있는가
7재기록 가능성한 번 쓰면 끝인가, 지우고 다시 쓸 수 있는가
실무에서 6·7번이 결정적인 이유

1~5번은 스펙시트에 존재 · 아카이브 프로젝트의 실제 실패 요인 = "읽을 장치가 없어짐(6)"과 "고칠 수 없음(7)" · DNA는 6번에서 압도적 우위, 7번은 아직 약함

퀴즈 1 — 1강 확인

옆 사람과 30초씩 대화 후 답변

1
점토판은 3,000년을 살아남았는데 플로피디스크는 30년 만에 못 읽는다. 무엇이 달랐는가?힌트 — 매체의 물리적 열화 vs. 판독 장치 소멸 · 서로 다른 두 문제
2
SLC에서 QLC로 갈 때 밀도는 4배가 된다. 무엇을 대가로 지불하는가?힌트 — 전압 준위 간 마진·오류율·P/E cycle
3
LTO 테이프가 $/TB로 가장 싼데도 100년 보존에 부적합할 수 있는 이유는?힌트 — 매체 비용이 아닌 유지 비용 · 마이그레이션 8~10회
제 2 강

DNA 데이터 저장 프로세스와 역사

문제 정의 — 동결 아카이브 계층이 비어 있음
그 자리에 DNA가 저장매체로 들어가는 방식

PART 4

왜 DNA인가

Why DNA?

  • DNA가 잘하는 것 — 밀도·수명·에너지·영속성
  • "1kg의 DNA" 비유 직접 계산
  • DNA가 못하는 것 — 비용·속도·파괴적 읽기

STORAGE LIMITS

A. Extance, Nature (2017) — 세 매체의 정면 비교
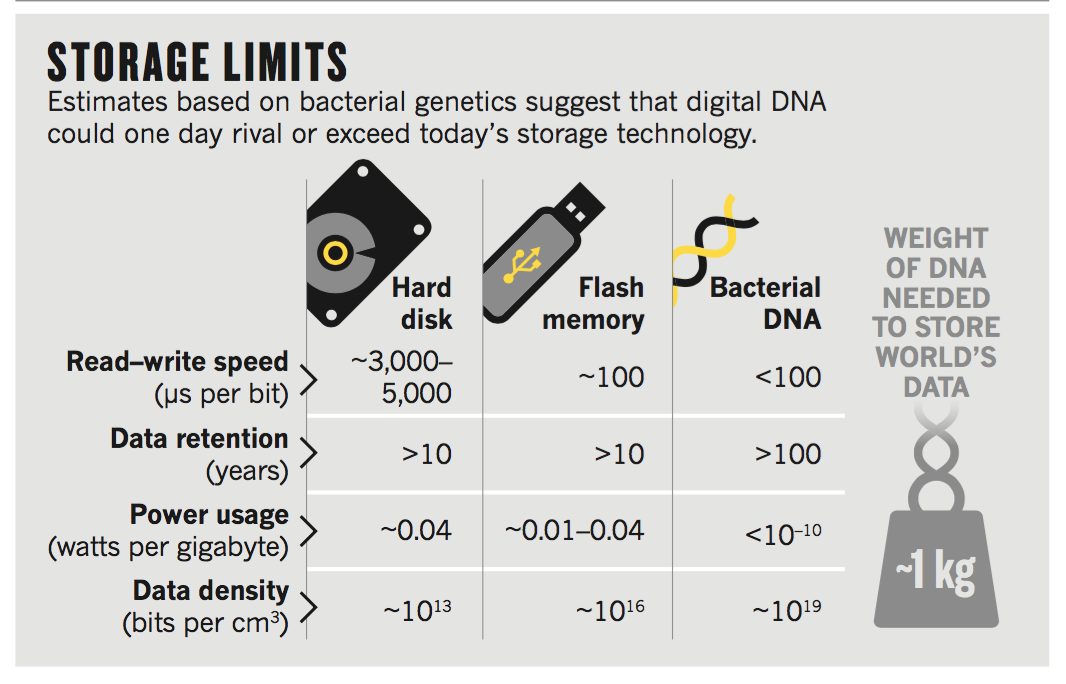
Storage limits: hard disk, flash memory, bacterial DNA 비교 (Nature 2017)
  • 읽고 쓰는 속도 — DNA도 나쁘지 않다?
    • 비트 단위 비교는 타당 · 문제 = 처리량·준비 시간
  • 데이터 보존 — >100년
    • HDD·플래시는 >10년 · 한 자릿수 차이 아님
  • 전력 — <10⁻¹⁰ W/GB
    • HDD 대비 10⁸배 이상 낮음 · 사실상 0
  • 데이터 밀도 — ~10¹⁹ bits/cm³
    • 플래시(~10¹⁶)보다 1,000배, HDD(~10¹³)보다 100만 배.

"1 kg의 DNA"

정보밀도

주어진 값

  • 뉴클레오티드 평균 분자량 ≈ 325 g/mol
  • nt당 정보 이론 상한 = 2 bits (4염기 = 2²)
  • 아보가드로 수 = 6.022 × 10²³ /mol

계산

(1 g ÷ 325) × 6.022×10²³ ≈ 1.85 × 10²¹ nt
1.85×10²¹ × 2 bits = 3.71 × 10²¹ bits
= 4.63 × 10²⁰ byte ≈ 463 EB/g

⚠️ 이론 상한

실제 시스템에서 빠지는 것들

  • 프라이머 결합부위 (양쪽 각 ~20 nt)
  • 인덱스 / 주소 영역
  • 오류정정 중복분 (원본 대비 +30~50%)
  • GC·호모폴리머 제약에 의한 코딩 효율 손실
  • 각 서열을 여러 카피로 합성 (coverage)

→ net density = 보통 1.0~1.8 bits/nt

[퀴즈] 직접 계산

150 nt 올리고에서 양쪽 프라이머 20 nt씩, 인덱스 16 nt를 뺀 payload에 1.8 bits/nt를 적용하면
올리고 하나에 실제로 저장되는 정보는 몇 비트인가?

수명 — 매머드의 증거

이론이 아닌 화석 기록

100만 년+시베리아 영구동토층 매머드 표본에서
추출·시퀀싱된 DNA
수백~수천 년실리카 캡슐화 + 저온·건조 조건
가속열화(Arrhenius) 외삽 결과
≈ 0 W보관 중 소비 전력
냉동고든 실온 건조 캡슐이든
★ 단편화에도 판독된 매머드 DNA

장기 보존 목표 = "분자가 온전히 남는 것"이 아닌 "정보가 복원 가능한 것"
단편화·일부 소실에도 충분한 중복성·오류정정 코드가 있으면 원본 복원 가능

  • 가장 저평가된 장점 — 포맷 진부화 없음
    • LTO-4 판독에는 전용 드라이브 필요 · 드라이브 단종 위험
    • DNA 판독 능력은 생명과학이 존재하는 한 지속 · 매년 저렴·고속화
    • 복제 비용도 거의 0 · PCR 한 번으로 지수 증폭
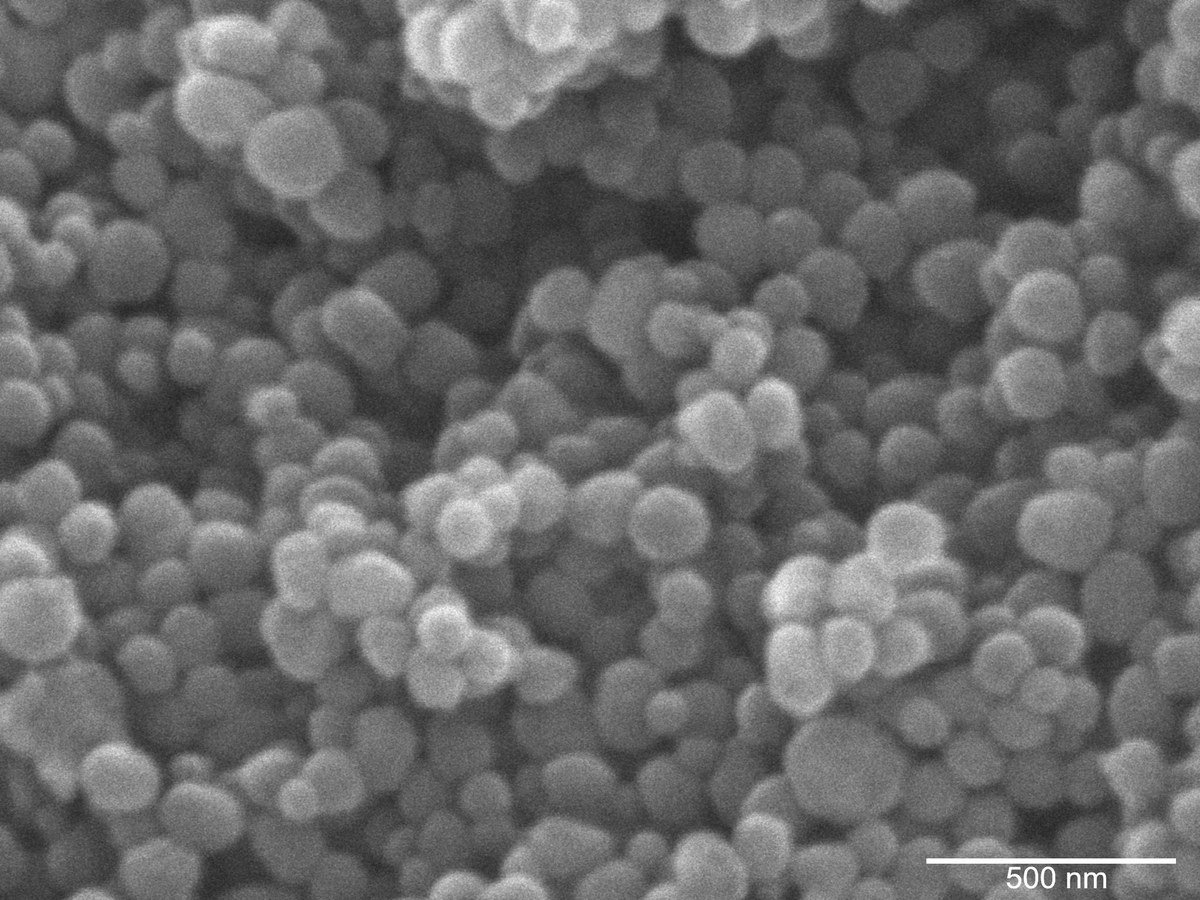
메조포러스 실리카 전자현미경 사진

메조포러스 실리카 (DNA 봉입 매체)

DNA의 한계점

다양한 장점에도 불구하고 현실적으로 존재하는 문제점

쓰기 비용

현재 MB당 수백~수천 달러 수준
HDD($0.02/GB급) 대비 6~8자릿수 차이
→ 상용화 최대 관문

쓰기·읽기 속도

합성은 시간~일, 시퀀싱은 수 시간
hot/warm 계층 후보로 부적합

파괴적 읽기

시퀀싱은 시료 소모
PCR 증폭 판독 가능하나 편향(bias) 유발 및
반복 시 오류 누적

오류율

합성·보존·PCR·시퀀싱 모든 단계에서
치환·삽입·삭제와 가닥 소실(dropout).
→ ECC가 선택이 아니라 필수 (4장)

랜덤 액세스

수백만 종 올리고가 한 방울에 혼합
특정 파일 회수에 프라이머 직교성 설계와
교차반응 회피 필요 (9장)

정직한 결론

DNA는 DRAM·SSD를 대체하지 않음

DNA의 자리 = LTO 아래
"동결 아카이브" 계층

경쟁 지표 = $/GB가 아닌
100년 TCO

PART 5

DNA 구조와
정보 표현

Structure & Information Encoding

  • 화학 구조와 방향성 — 왜 5′→3′이 중요한가
  • 상보성·이중나선과 기하학적 수치
  • 4염기 = 2 bits, 그러나 공짜가 아닌 이유

DNA 화학 구조 복습

뉴클레오티드 = 당 + 인산 + 염기

  • ① 디옥시리보스 (5탄당)
    • 2′ 위치에 OH 없음 — RNA와의 결정적 차이 · DNA 안정성 우위
  • ② 인산기
    • 음전하 → 전기영동 분리·전기장 조작 가능
  • ③ 염기 — 퓨린(A, G) / 피리미딘(C, T)
    • 정보를 담는 부분 · 나머지 둘은 "골격"
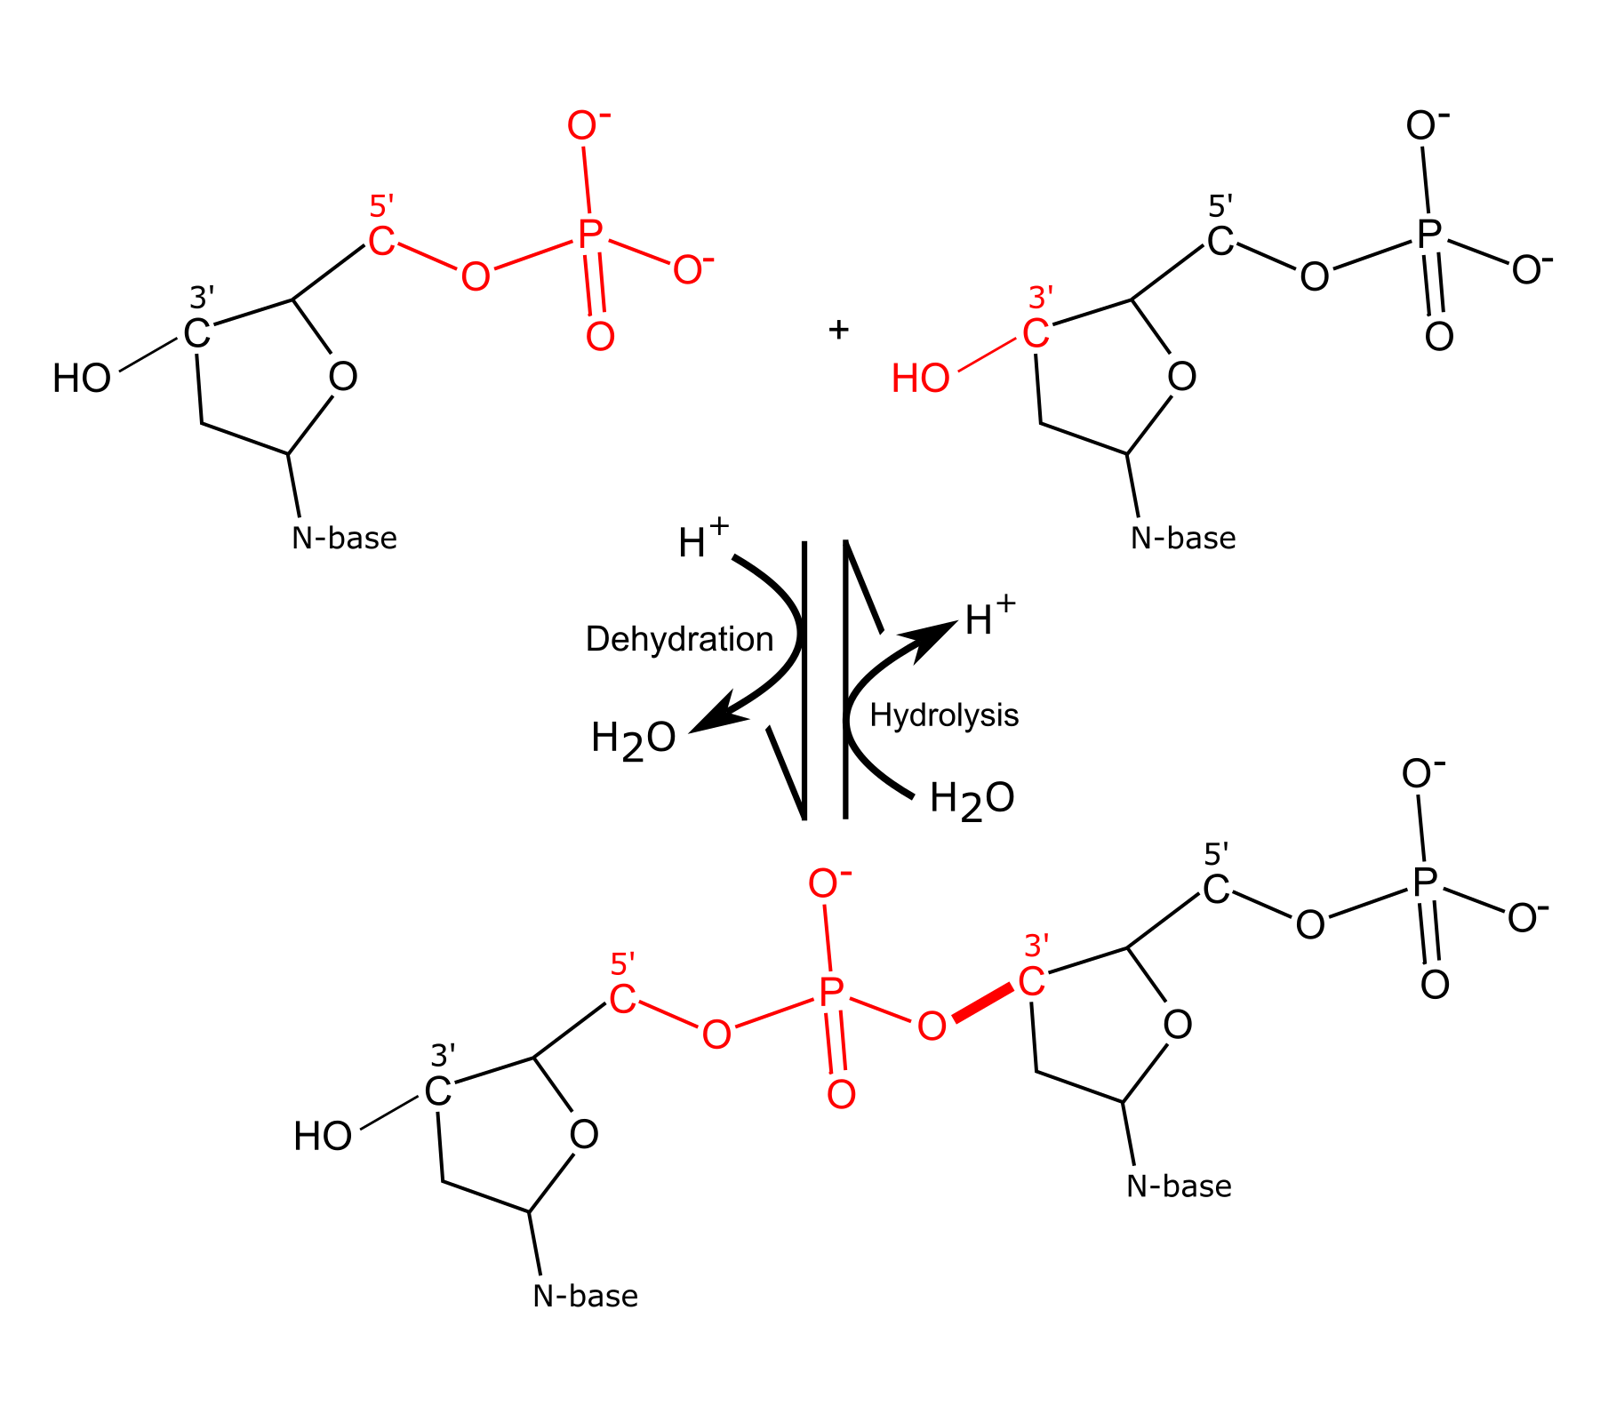
포스포디에스테르 결합의 형성(탈수 축합)과 가수분해

★ 방향성 — 필수 기억

포스포디에스테르 결합: 한 뉴클레오티드의 3′-OH와
다음 뉴클레오티드의 5′-인산 연결

→ DNA 가닥 방향: 5′ 말단 → 3′ 말단

자연의 DNA 중합효소: 5′ → 3′ 방향으로만 합성

화학적 포스포라미다이트 합성: 3′ → 5′ 방향

이 방향 차이 = 6장(화학적 합성)과 7장(효소적 합성)의 분기점

생명분자가 정보분자의 활용

DNA = "그냥 4진수 문자열" · 그러나 저장 한계(길이 제한·호모폴리머·합성 방향)는 모두 이 화학에서 기원
분자 구조 이해 → 200 nt 길이 한계 이해

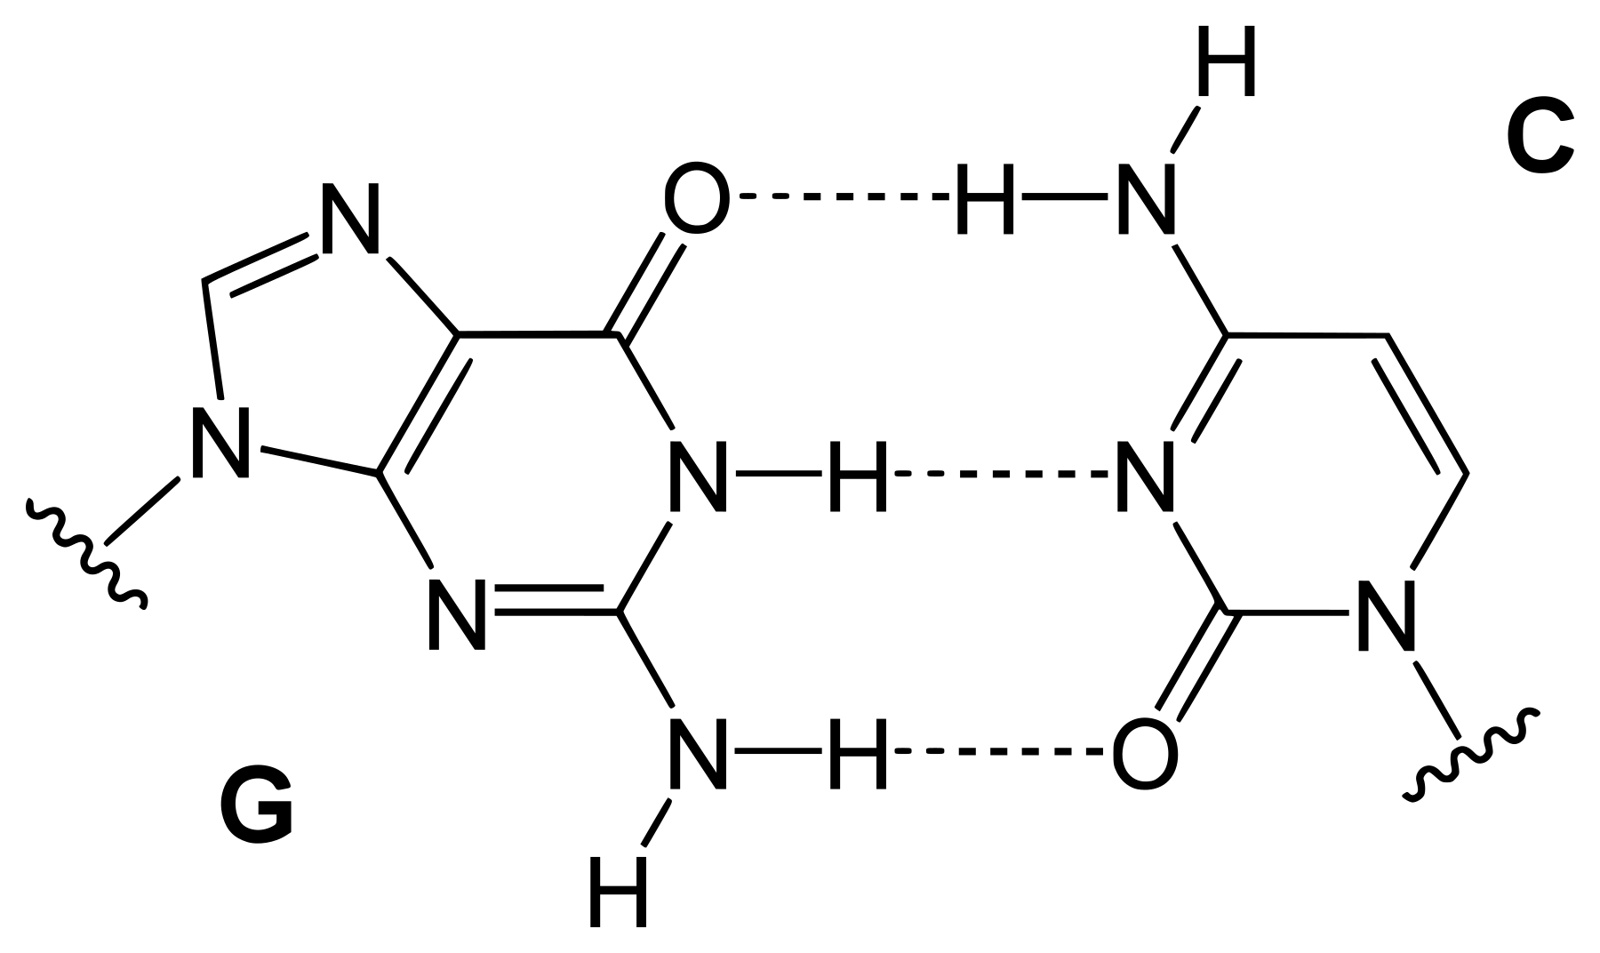
상보성 · 이중나선 · 기하학적 수치

DNA 부피 밀도의 기하학적 근거
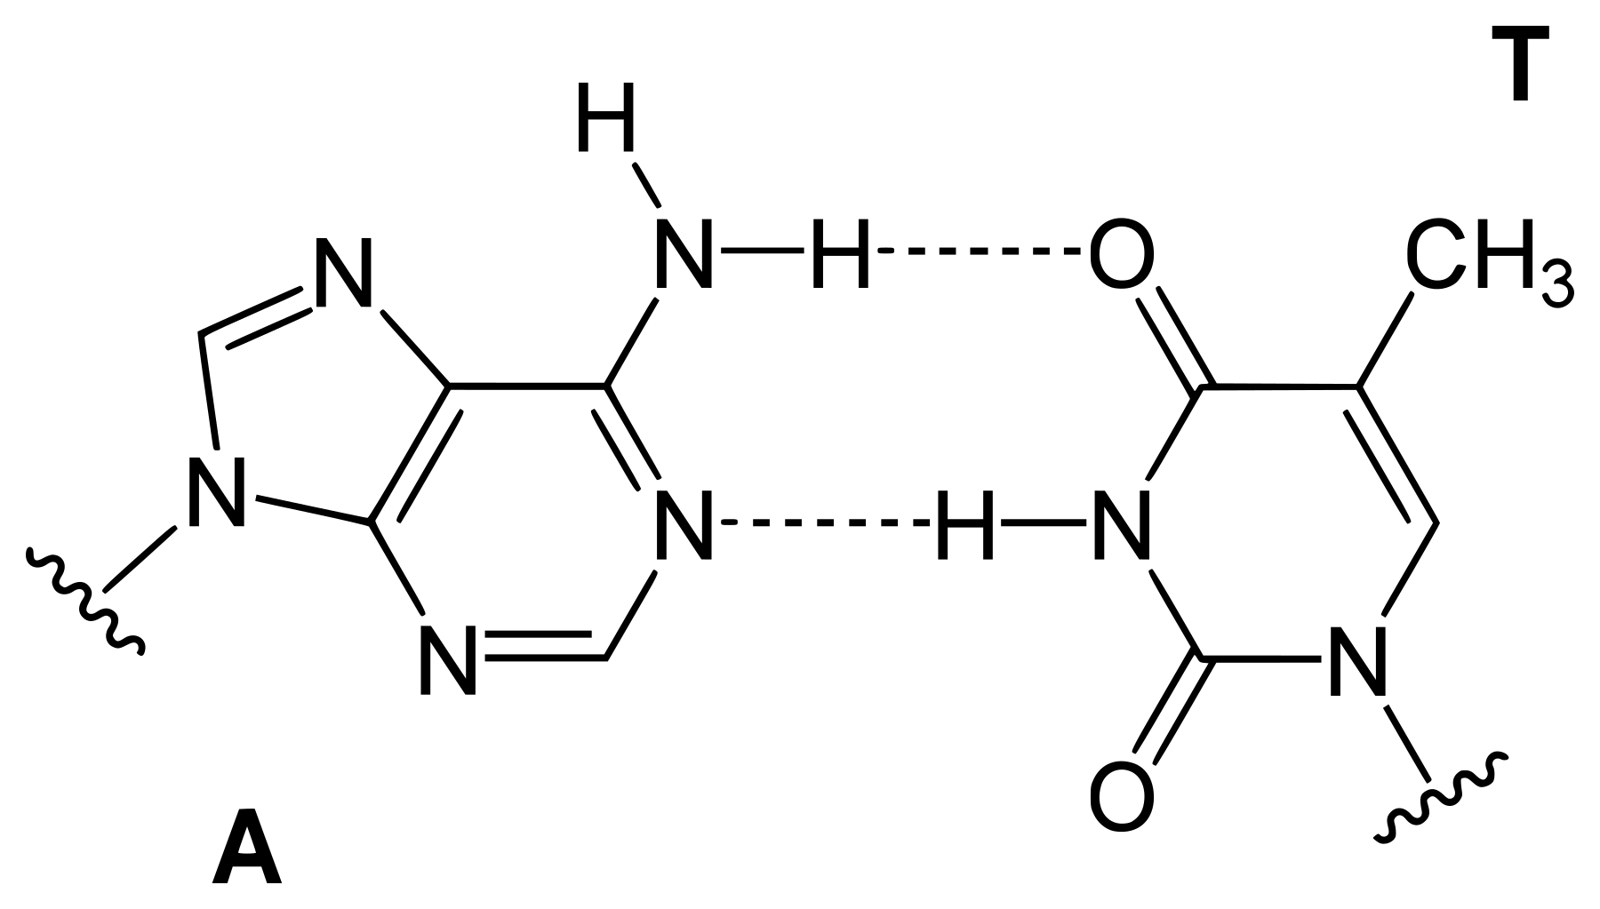
A–T 염기쌍, 수소결합 2개

A = T · 수소결합 2개

G–C 염기쌍, 수소결합 3개

G ≡ C · 수소결합 3개

→ GC 함량 증가 → Tm(녹는점) 상승

B-form DNA 기하

  • 염기쌍 간 거리 ≈ 0.34 nm
  • 나선 피치 ≈ 3.4 nm (약 10.5 bp)
  • 이중나선 지름 ≈ 2 nm
두 가닥의 역평행성(antiparallel)

한 가닥이 5′→3′이면 짝은 3′→5′ · 프라이머 방향 오류 시 증폭 불가

밀도 계산의 출발점

굵기 2 nm, 길이 방향 0.34 nm/bp에 2 bits → 비트당 부피 약 1 nm³
최신 3D NAND의 비트당 부피와 비교 필요 · "10¹⁹ bits/cm³"의 물리적 근거

4염기 = 2 bits의 대가

생물학적 제약에 따른 코딩 효율 감소

제약내용왜 문제가 되는가
호모폴리머동일 염기 연속 ≤3개합성 결실·나노포어/pyrosequencing 길이 오류
GC 함량40~60% 유지저GC: 낮은 Tm·불안정 프라이밍 / 고GC: 이차구조·합성 난도 증가
이차구조헤어핀·자기상보 서열 회피PCR·시퀀싱 방해
금지 motif제한효소·프라이머 유사 서열 회피비의도 절단·교차반응
서열 유사성올리고 간 충분한 편집거리클러스터링·디코딩 혼동
[퀴즈] 사고 문제

호모폴리머를 최대 3개로 제한하면 nt당 정보량의 이론 상한은 2 bits보다 얼마나 줄어드는가?
힌트: 제약을 만족하는 서열의 개수를 세는 문제 → 점화식과 채널 용량

코딩 이론의 필요성

제약 준수와 정보 밀도 최대화 = 3장(인코딩)·4장(ECC)·5장(해시·분수코드)의 전부
오늘 목표 = "왜 필요한지" 이해

PART 6

저장 프로세스
6단계

The End-to-End Workflow

  • 디지털 파일 → DNA 분자 → 다시 파일
  • 각 단계의 입력·출력과 오류원
  • DNA 저장 = 잡음 있는 통신 채널

DNA 데이터 저장의 6단계

과목 전체의 핵심 도식

①
인코딩Encoding

bits → ATGC
+ 인덱스·프라이머·ECC

3·4·5장
→
②
합성Synthesis

서열 → 실제 분자
화학적 / 효소적

6·7장
→ → →
⑤
시퀀싱Sequencing

분자 → 서열 판독
Illumina/ONT/PacBio

10장
→
⑥
디코딩Decoding

read → consensus
→ ECC 복호 → 파일

11·12·13장

디지털 파일 ─────────────▶ 복원 파일 (원본 해시 일치 = 성공)

오늘의 핵심 도식

인코딩 → 합성 → 보존 → 접근 → 시퀀싱 → 디코딩 · 남은 13주 = 여섯 단계의 확대 학습

실제 시스템 구성

Xin Song et al., ACS Nano (2019) — 7단계 상세 워크플로
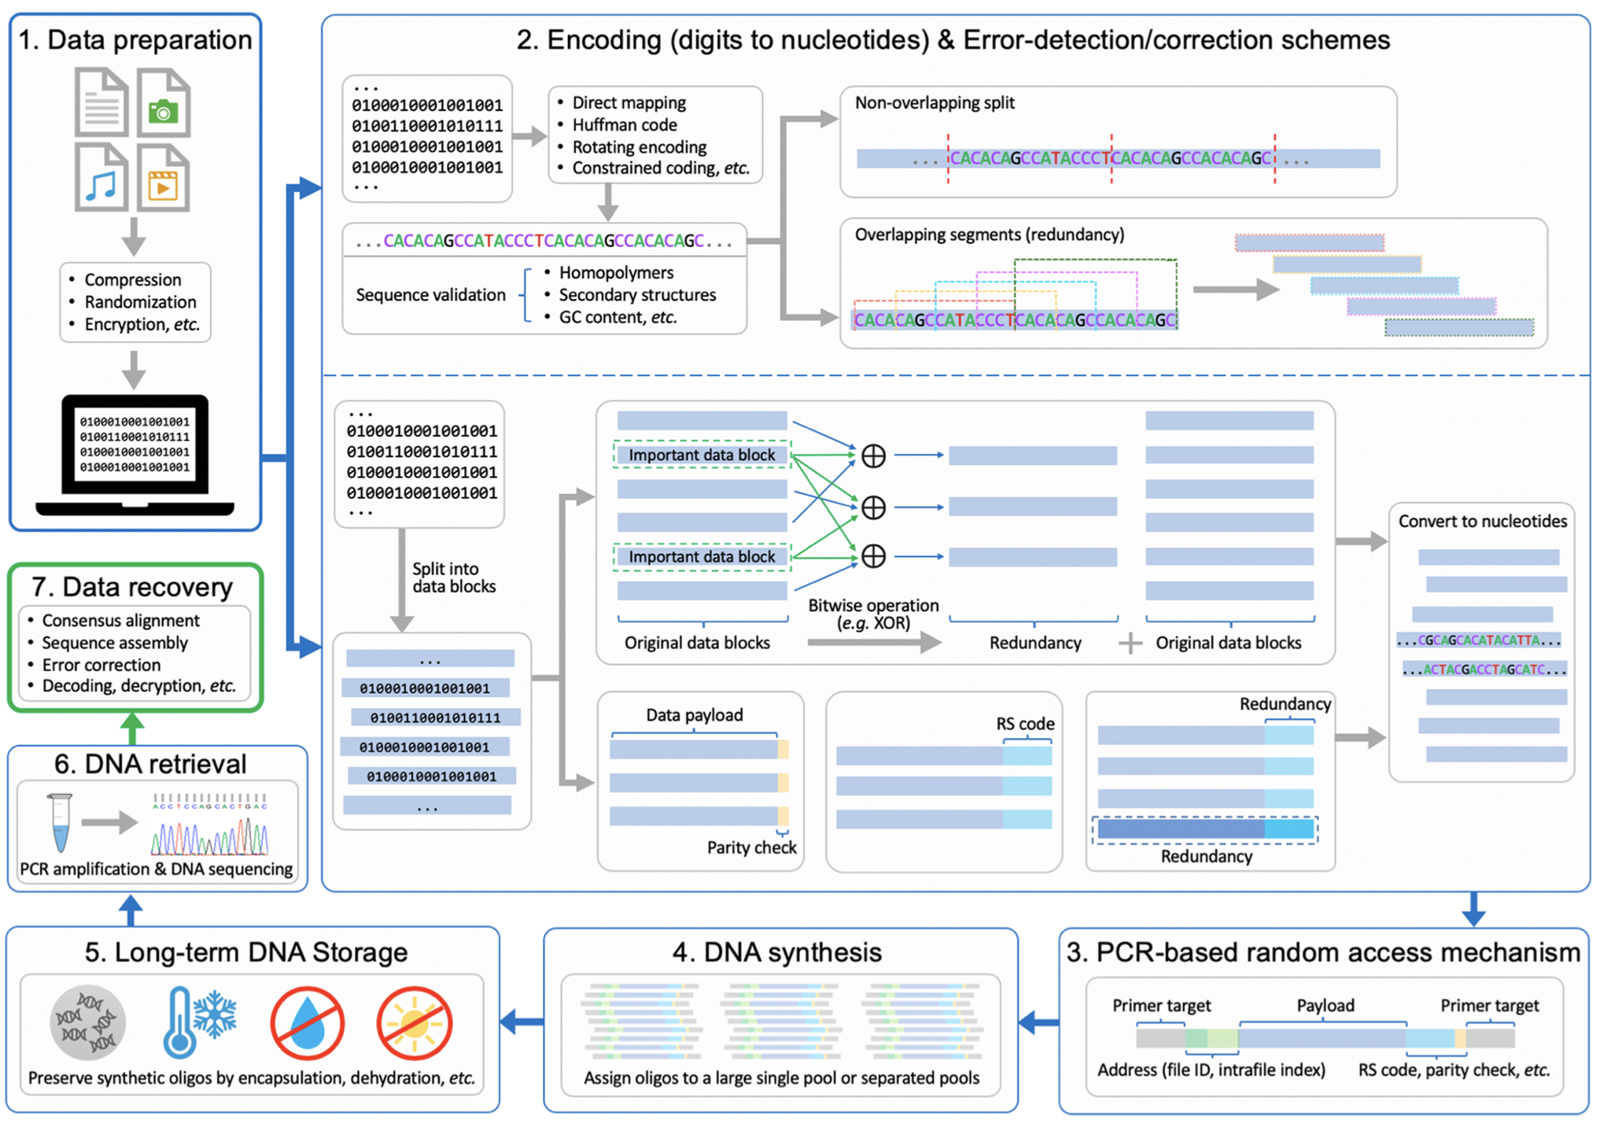
DNA 데이터 저장 7단계 워크플로 (Song et al., ACS Nano 2019)
읽는 순서

1 데이터 준비 → 2 인코딩·ECC → 3 PCR 기반 random access 설계 → 4 DNA 합성 → 5 장기 보존 → 6 DNA 회수 → 7 데이터 복원

단계별 입력 · 출력 · 오류원

어디서 무엇이 깨지는가

단계입력출력주요 오류 · 손실
① 인코딩바이너리 파일FASTA 집합(오류 아님) 코딩 효율 저하·제약 위반
② 합성FASTAoligo pool치환·결실·삽입·절단체·농도 편차
③ 보존oligo pool보존된 DNA가수분해, 산화, 탈퓨린화, 단편화
④ 접근DNA pool + 프라이머증폭 부분집합PCR bias·비특이 증폭·교차반응·시료 소모
⑤ 시퀀싱증폭 산물FASTQ reads플랫폼 오류(치환/indel)·coverage 편차·dropout
⑥ 디코딩FASTQ복원 파일클러스터링·consensus 오류·ECC 초과
★ 핵심 통찰 — DNA 저장 = 통신 채널 문제

송신자(인코더)의 메시지가 잡음 채널(합성-보존-PCR-시퀀싱)을 거쳐 수신자(디코더)에서 복원됨
샤논 정보이론·통신 오류정정 코드 직접 적용
다만 치환·삽입·삭제·가닥 전체 소실(erasure)이 함께 발생하는 특수 채널

올리고 하나의 구조

전체 길이 보통 150~300 nt

5′3′
Forward
Primer
Payload
ECC
Reverse
Primer
~20 nt
~16–24 nt
~100 nt
가변
~20 nt
랜덤 액세스용
순서 복원용
실제 데이터
오류 정정
랜덤 액세스용
[계산]

200 nt 올리고, 프라이머 20 nt × 2, 인덱스 20 nt, ECC 20 nt → payload 120 nt.
2 bits/nt면 240 bits = 30 byte. 1 MB 파일을 저장하려면 올리고가 몇 종 필요한가?

답

1 MB = 1,048,576 byte ÷ 30 byte ≈ 약 35,000종.
ECC 중복·물리 coverage 반영 시 실제 합성량 대폭 증가

길이는 왜 150~300 nt에서 멈추는가

화학적 합성 사이클당 결합 효율 99.5% 가정 → 200 nt에서 0.995²⁰⁰ ≈ 37%만 온전 · 누적 오류가 길이 제한 (6장)

PART 7

DNA 저장의 역사

From Art to Industry

  • 1988년, 예술 프로젝트로 시작됨
  • 2012~2017 — 대용량이 열린 6년
  • 밀도는 왜 2 bits/nt에서 멈췄는가

태동기 — 예술적 출발

1960s ~ 2000s : 용량 KB 미만의 시대

연도사건의미
1964–65Mikhail Neiman, 소련 학술지에 DNA 정보 기록 아이디어 발표최초 개념 제안
1988Joe Davis, "Microvenus" — 룬 문자 이진 이미지를 대장균 DNA에 삽입최초 실물 시연·예술 프로젝트
1999Clelland et al., Nature — DNA microdot 스테가노그래피정보 은닉 응용
2001Bancroft et al., Science — 3염기 = 1문자 코돈형 인코딩체계적 인코딩 규칙 등장
2003Wong et al. — 살아있는 세포 게놈에 정보 삽입in vivo 저장 초기 사례
이 시기의 특징

목적은 "저장"이 아닌 "가능성의 증명" · 대량 합성과 저렴한 시퀀싱 부재
2012년 이후 도약 = microarray 기반 대량 병렬 합성과 NGS 비용 급락의 동시 성숙

DNA 데이터 저장 마일스톤 타임라인

1953 → 2024

DNA 데이터 저장 발전사

좌우 교차 순서
1960s 개념 → 예술 → 2012 대용량
2013 캡슐 → 2017 in vivo
2018 random access → 2023 카드
2024 표준

그림의 오류

"1966 — Joe Davis, Microvenus"는 오류 · Microvenus는 1980년대 후반(통상 1988년) 작업
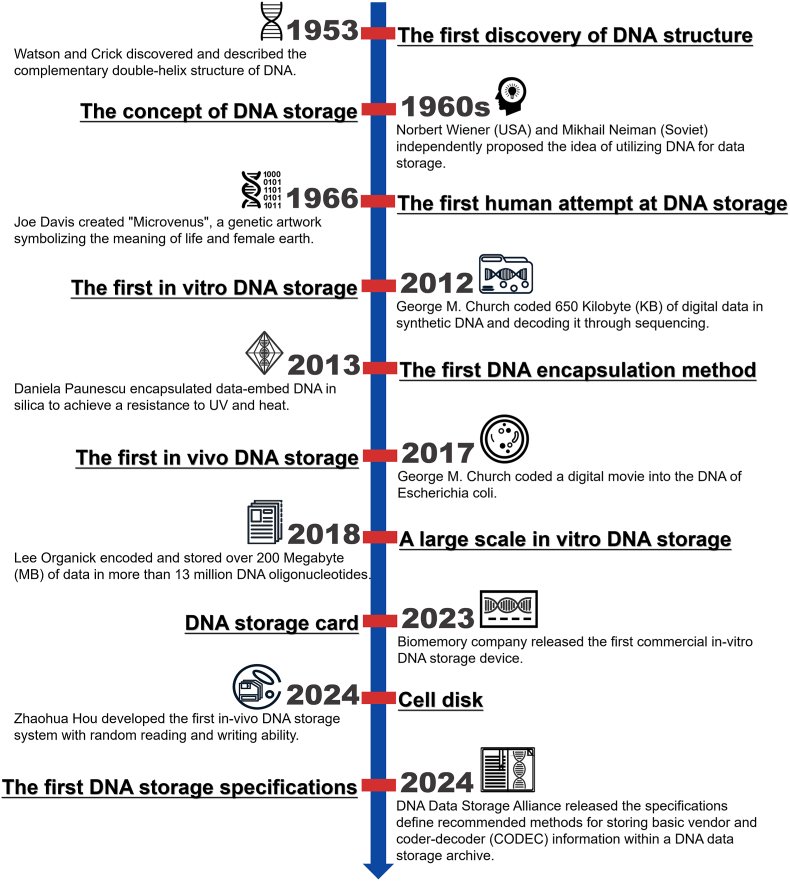
DNA 데이터 저장 마일스톤 타임라인 1953–2024
4가지 강조 지점

① 2012 Church — "책 한 권" 규모 첫 달성

② 2013 Grass/Paunescu — 실리카 캡슐화로 "보존"의 공학 문제화

③ 2018 Organick — 200 MB + random access · 시스템의 시대

④ 2024 DNA Data Storage Alliance 스펙 — 산업 표준의 시작

DNA 데이터 저장 마일스톤 타임라인
  • Harvard

    Joe Davis, 최초의 DNA 정보 저장 이용사례, 이미지 파일을 대장균 속에 저장,1988
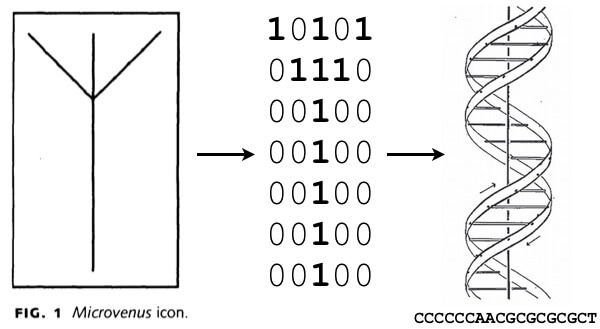
    Microvenus icon과 이진 인코딩
  • Harvard

    George Church, 53,400자 분량의 책, 11개의 이미지 파일, 자바 스크립트 프로그램을 대장균 속에 저장. ,2012
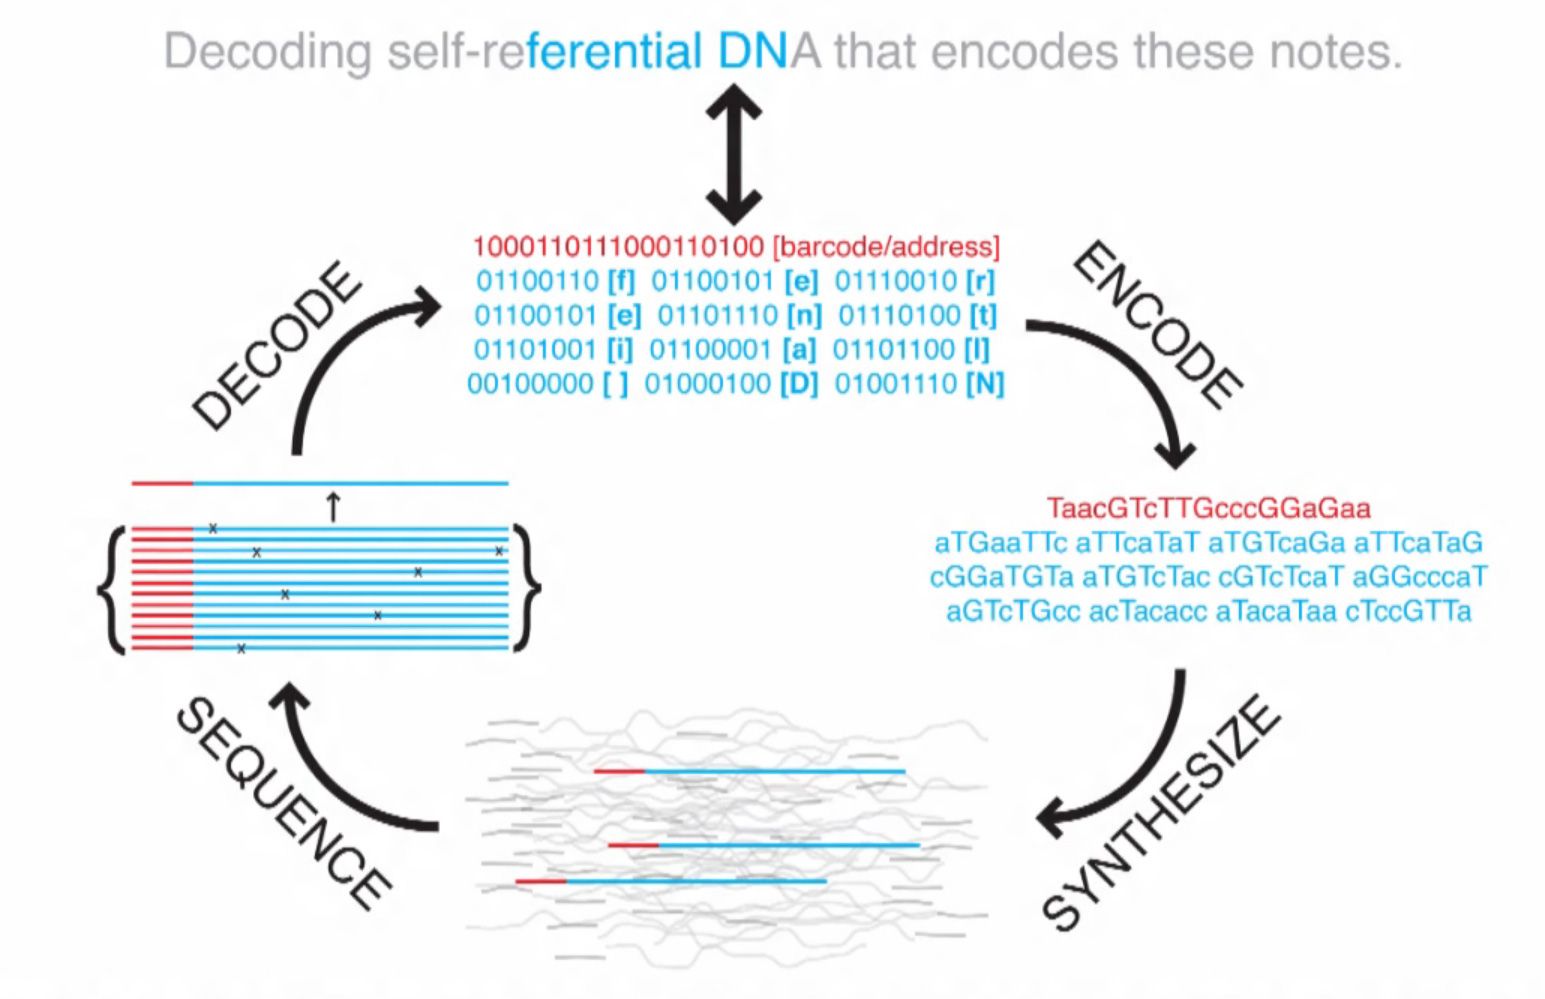
    Church 2012 인코딩·시퀀싱 순환 도식
  • EMBL-EBI

    Nick Goldman, 오류 정정 코드 도입을 통해 정보 추출 정확도를 99.99%-100%까지 개선, 2013
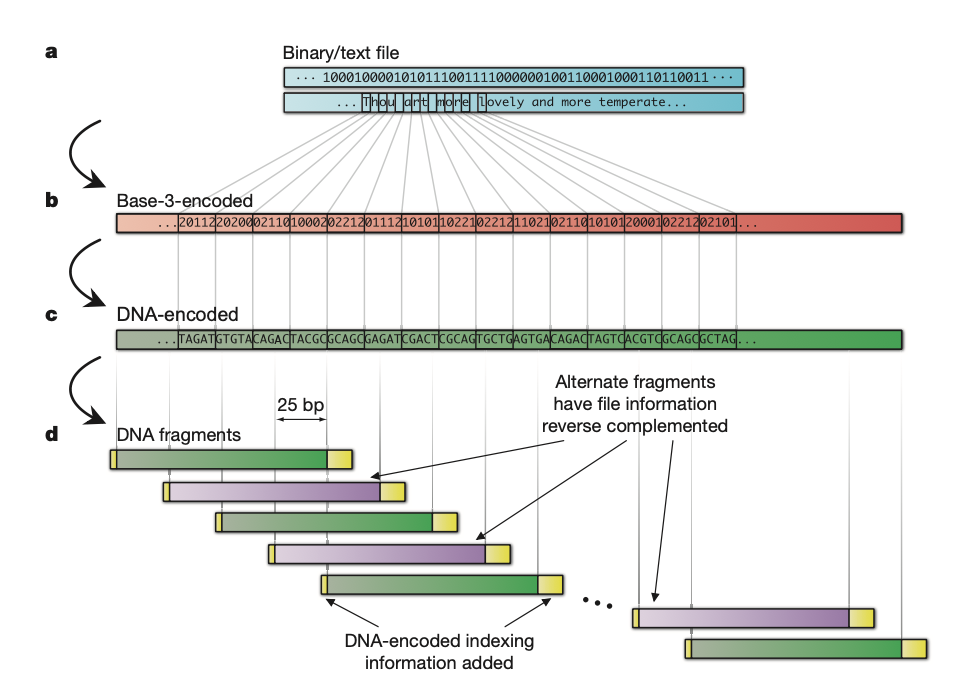
    Goldman 2013 인코딩 도식
  • Columbia University

    Yaniv Erlich, 새로운 인코딩 기술, DNA Fountain을 통해 DNA의 정보 집적도와 오류 정정를 개선, 2017
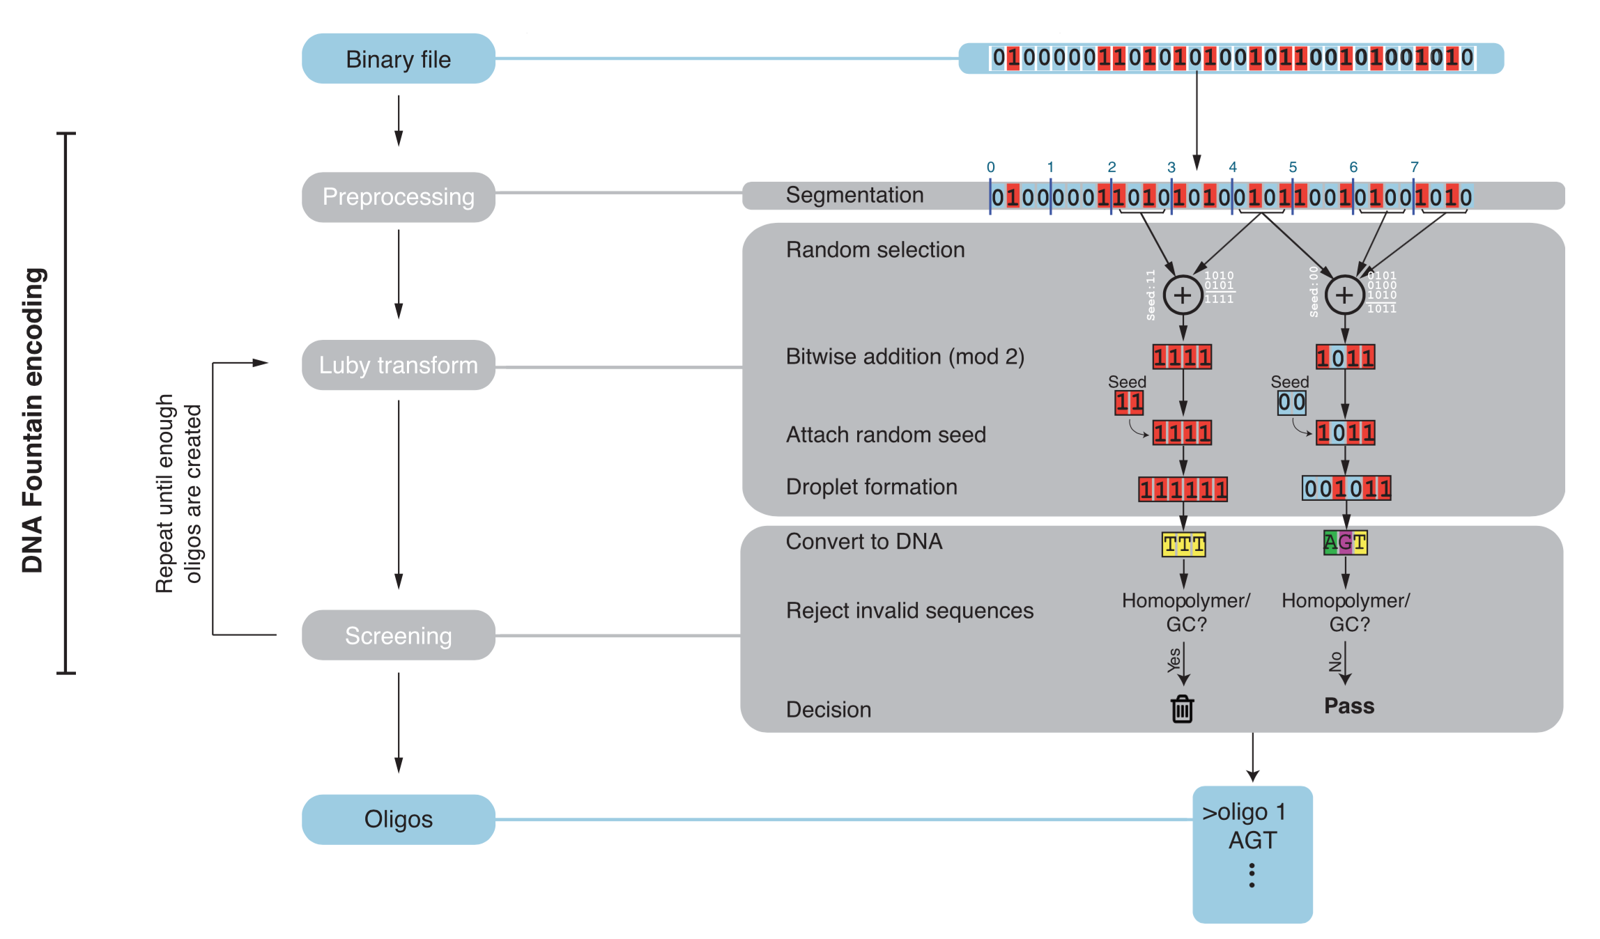
    DNA Fountain 인코딩 흐름도
  • Microsoft

    Luis Ceze & Karin Strauss, 인덱싱과 프라이머를 활용한 랜덤 액세스 기술을 통해 선택적 정보 추출, 2018
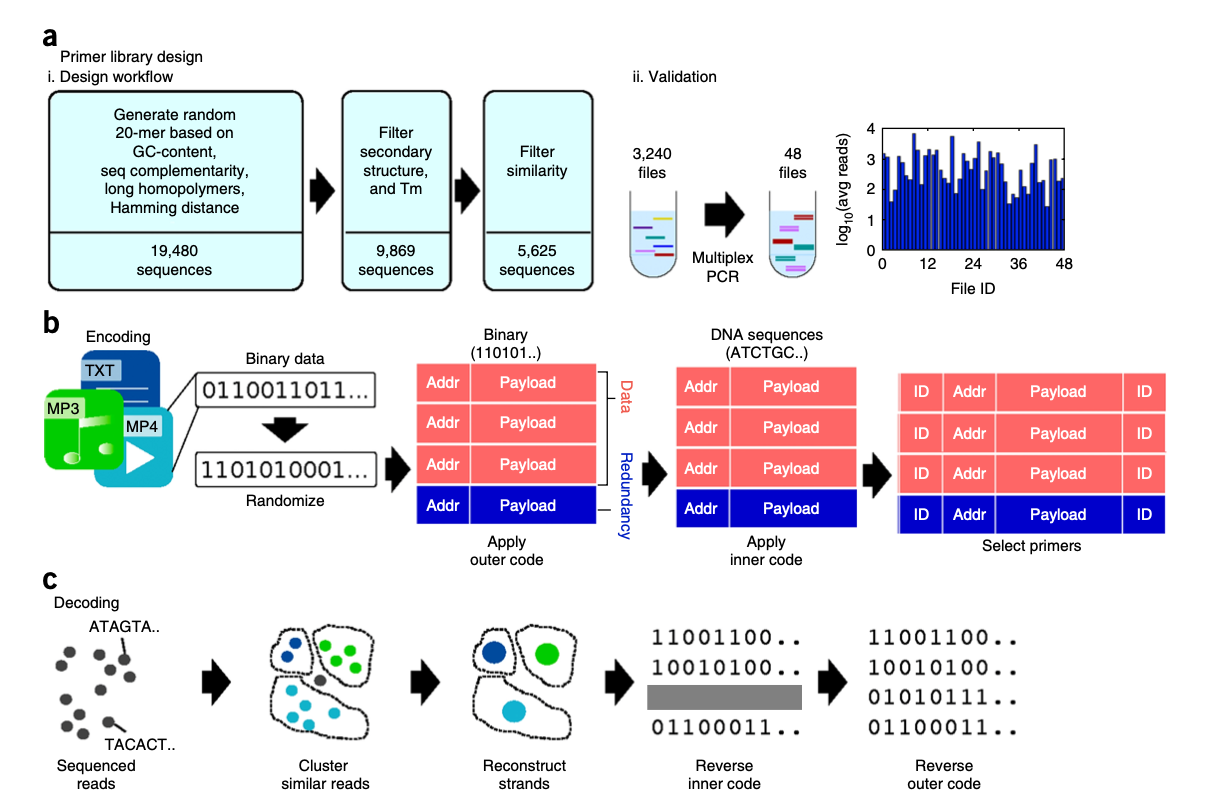
    Organick 2018 random access 도식
  • ETH Zürich

    Robert Grass, 3D 프린팅 DNA를 통하여 물질 속 장기 보관이 가능한 DNA of Thing 구현, 2019
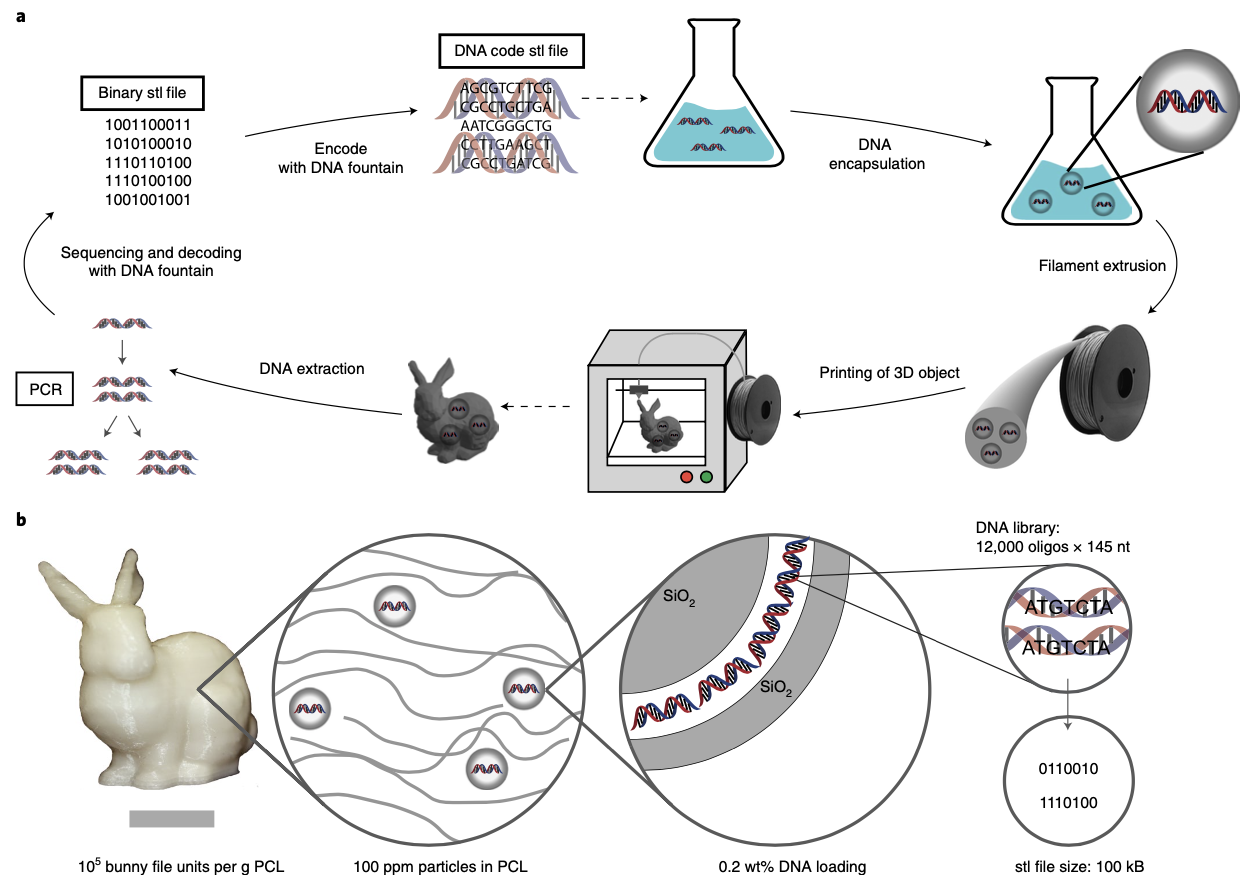
    DNA of Things 도식
  • CATALOG

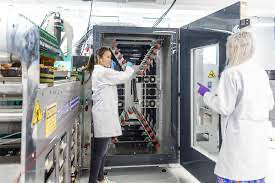
    24 시간동안 1TB의 정보를 쓸 수 있는 기술에 성공, 시리즈 B 펀딩 (한화 등)
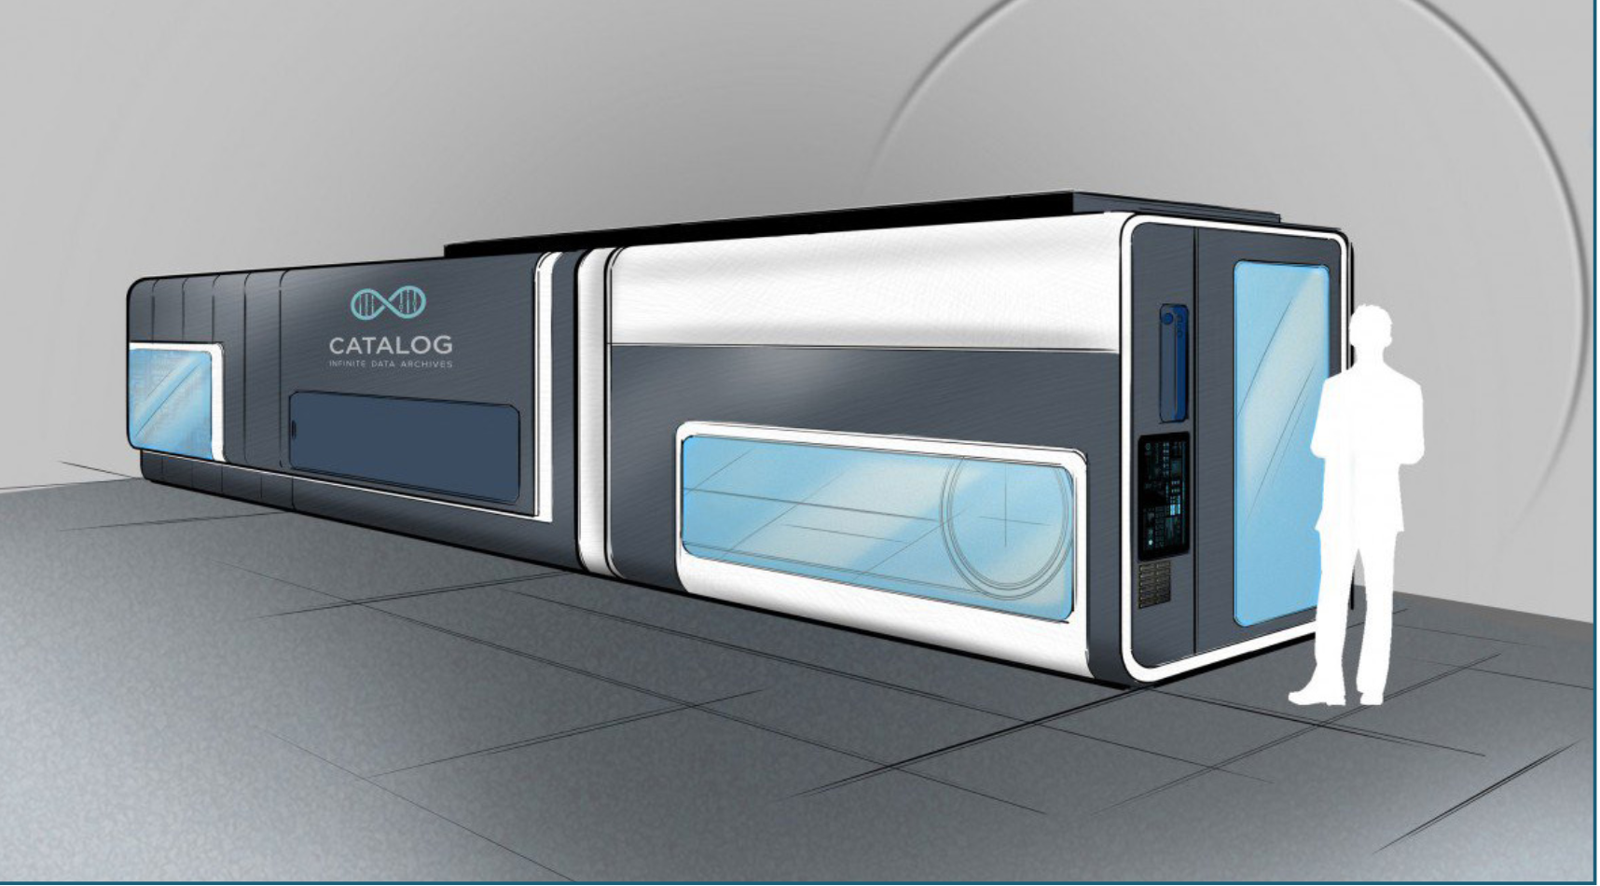
    CATALOG Shannon 장치CATALOG 실험실
  • DNA Data Storage Alliance

    주요 기업과 연구진들이 모여 DNA Data Storage Alliance 를 설립, 2020
    Illumina · Microsoft · Twist Bioscience · Western Digital
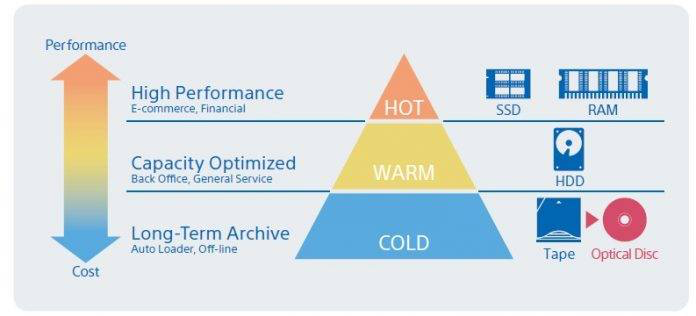
    스토리지 계층 피라미드
  • intelEURECOM · OligoArchive

    Raja Appuswamy, 30분 미만의 데이터 처리를 할 수 있는 알고리즘을 개발, 2021
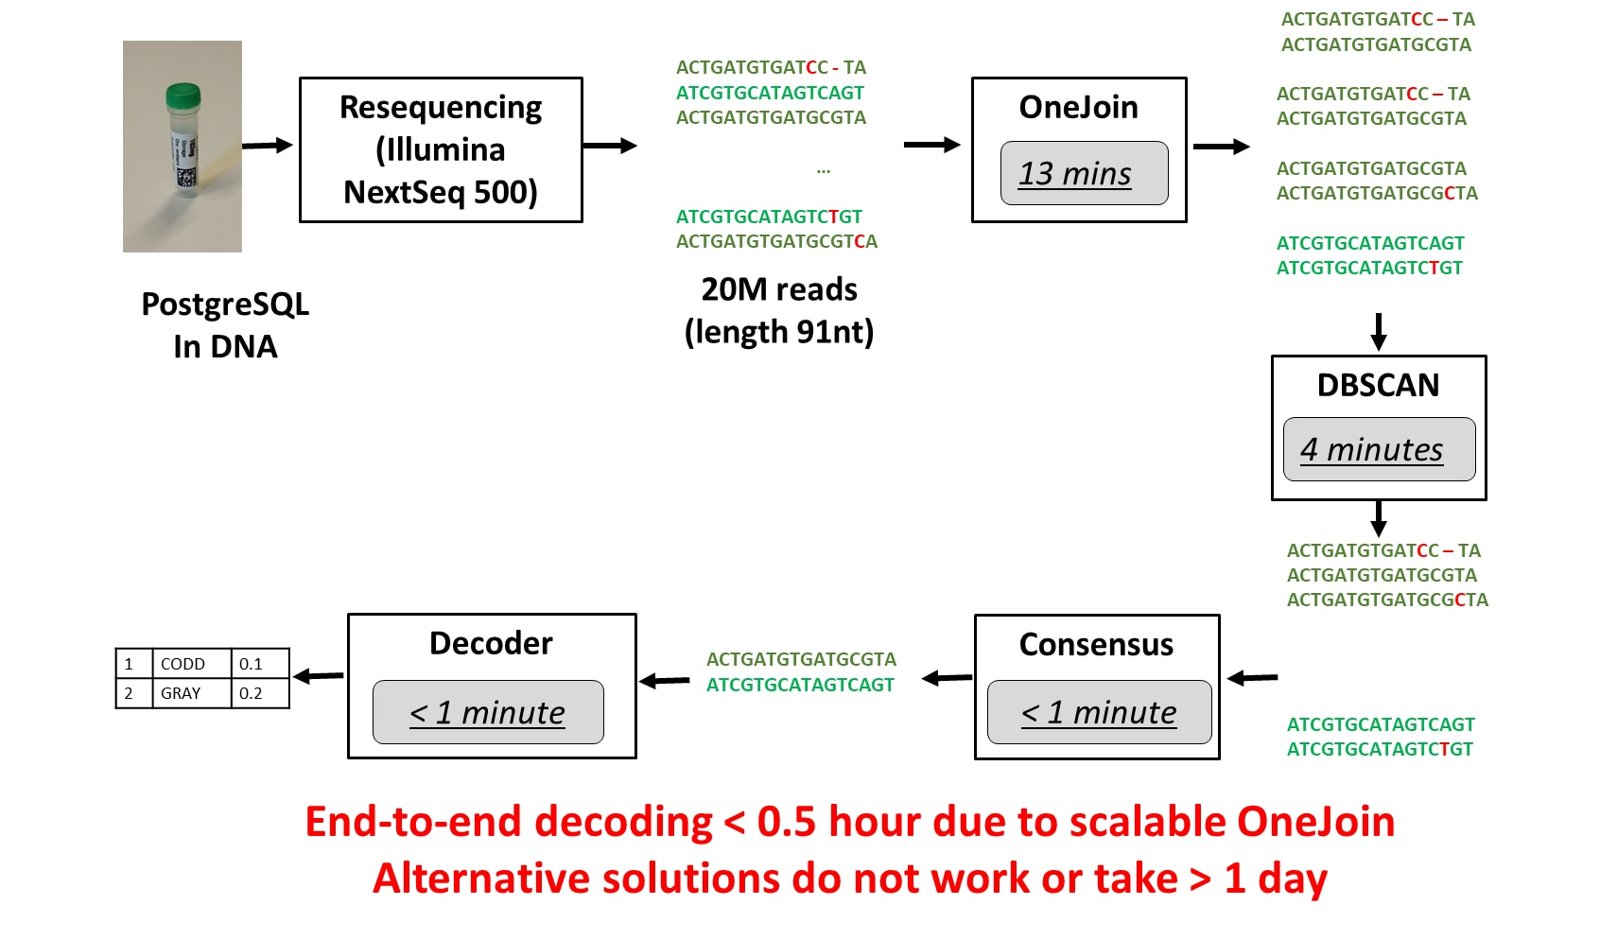
    OligoArchive 30분 디코딩 파이프라인
  • IRIDIABIOMEMORYFUJIFILMMolecular AssembliesIRIDIA 장치roswellLenovoANSASEAGATE

도약기 — 대용량이 열린 6년

2012 ~ 2017 : 코딩 이론의 DNA 진입

연도연구용량핵심 기여한계
2012Church et al. (Science)~659 KBmicroarray+NGS·첫 "책 한 권" 규모ECC 없음·저밀도
2013Goldman et al. (Nature)~739 KBHuffman 삼진+회전 매핑·호모폴리머 차단검출만·정정 불가
2015Grass et al. (Angew. Chem.)~83 KBReed–Solomon 첫 도입·실리카 열가속소용량
2016Bornholt et al. (ASPLOS)~151 KBXOR 가변 중복·random access4개 중 3개만 무인 복원
2016Blawat et al.~22 MBFEC·1 byte→5 nt단일 변이 정정 취약
2017Erlich & Zielinski (Science)~2.1 MBDNA Fountain 분수코드·상한 근접손실 임계 초과 시 급격한 실패
읽어야 할 흐름

오류정정 없음 → 패리티(검출만) → Reed–Solomon(정정) → XOR(가변 중복) → 분수코드(최소 중복).
통신공학 60년의 코드가 5년 만에 DNA로 이식됨 · 4장·5장에서 직접 구현
George Church 사진

George Church

숫자로 보는 실제 구현

Xin Song et al., ACS Nano (2019) — Table 2
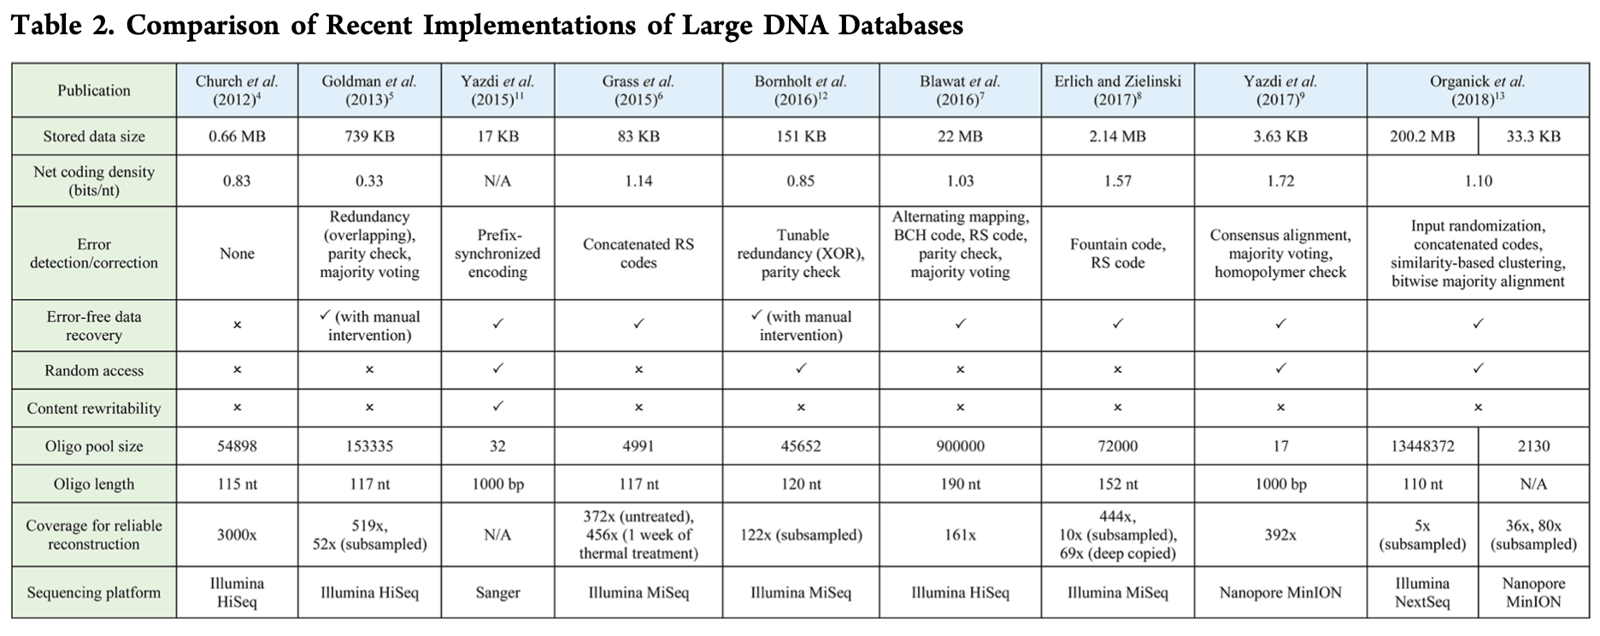
Table 2. Comparison of Recent Implementations of Large DNA Databases
★ "밀도" 정의 차이

시스템기와 현재

2018 ~ 현재 : 규모, 자동화, 그리고 새로운 축

  • 2018 Organick et al. (Nat. Biotechnol.)
    • 200 MB · 13,000개 이상 파일 random access · 파일별 직교 프라이머쌍 할당 → 현재 사실상 표준
  • 2019 Takahashi et al. (Sci. Rep.) — Microsoft + University of Washington
    • 완전 자동화 end-to-end 장치로 "HELLO" 쓰기·읽기 성공 · 21시간 소요 → 자동화 첫걸음이자 속도 문제 증거
  • 2020 Koch et al. (Nat. Biotechnol.) — DNA-of-Things
    • 3D 프린팅 물체 자체에 데이터 내장 · 안경테에 동영상 은닉 · 물체 복제 시 데이터도 복제
  • 2023 ~ 현재 새로운 축의 등장
    • 에피제네틱 저장 — 서열 유지·메틸화 등 화학 수식으로 정보층 추가 · de novo 합성 없이 "찍어내기"
    • 효소적 합성(TdT) 상용화 — DNA Script SYNTAX 등 벤치탑 효소 합성기 출시 (7장)
    • DNA Data Storage Alliance — 저장·바이오 업계의 매체·인터페이스 표준화 공동 추진
    • 국내 — 서울대 DNA 레이저 프린터, 문화유산 DNA 보존(직지·팔만대장경) 연구 진행

DNA 저장 역사의 핵심 패턴

용량 폭증과 밀도 정체

용량

KB → MB → 수백 MB

지수적 증가
병목은 항상 합성 비용

밀도 (coding potential)

1.0 → 1.58 → 1.78 → 1.98

이론 상한 2 bits/nt에
사실상 도달

그래서 다음 전선은

  • 합성 비용 / 속도 (6·7장)
  • Random access (9장)
  • 디코딩 속도 (12·13장)
  • 서열 외의 차원 (에피제네틱·3D)
결론

더 이상 "코딩만 잘해서" 얻을 여지 거의 없음 · 2 bits/nt 물리적 상한 도달
분야의 미래 = 정보이론보다 화학·공정·시스템 공학
→ 6장 이후 학습의 이유

퀴즈 2 — 2강 확인

오늘 배운 내용으로 답변 가능

1
DNA 합성은 화학적으로 3′→5′ 방향인데 중합효소는 5′→3′이다. 왜 이 차이가 중요한가?힌트 — 화학적 합성과 효소적 합성은 서로 다른 화학 사용 · 6장·7장의 분기점
2
Random access가 없다면 100 GB 아카이브에서 1 KB 파일 하나를 꺼낼 때 무슨 일이 벌어지는가?힌트 — 전체 pool 시퀀싱·디코딩 필요 · 비용·시간이 파일 크기와 무관해짐
3
DNA Fountain이 1.98 bits/nt를 달성했는데도 그것이 "최종 승자"가 아닌 이유는?힌트 — 밀도는 이미 상한 · 남은 병목은 코딩 외 영역

오늘의 정리

1강 + 2강 핵심 여섯 문장

  1. 저장 매체 역사 = 밀도·비용 확보와 수명·내구성 상실의 반복
  2. 데이터는 ZB 단위 폭증 / 대부분은 거의 읽지 않는 콜드 데이터
  3. 테이프 아카이브 근본 문제 = 주기적 마이그레이션·포맷 진부화
  4. DNA: 밀도·수명·에너지·포맷 영속성 우위 / 쓰기 비용·속도 열세
  5. DNA 저장 = 인코딩→합성→보존→접근→시퀀싱→디코딩의 6단계 통신 채널 문제
  6. 용량 폭증 / 밀도는 2 bits/nt에서 정체 · 다음 돌파구 = 화학·공정·시스템
핵심 용어

메모리 계층 · 콜드 스토리지 · 매체 마이그레이션 · 포맷 진부화 · retention · TCO · P/E cycle | 5′→3′ · 호모폴리머 · GC 함량 · Tm · oligo pool · payload · index · primer · coding potential · net information density · coverage · dropout · BER · random access

Q and A

“DNA는 기존 메모리를 대체하는 장치가 아니라, 비어 있던 동결 아카이브 계층의 후보다.”