MOLECULAR INFORMATION ENGINEERING 10-1
DNA Random Access
선택적 PCR과 분자 파일 접근
파일 주소와 분자 선택 / PCR 선택의 과정 / 접근의 한계와 대안 / 파일 복원과 설계 연습
송영준 Youngjun Song / 인천대학교 / 75분
분자 풀의 파일 접근
- 풀: 서로 섞인 많은 DNA 서열
- 파일 주소: 선택에 사용하는 공통 표지
- 선택 단계와 전체 풀 시퀀싱의 차이
- 선택 후 원본 데이터의 복호
주소의 세 층위
| 구분 | 선택 시점 | 역할 |
|---|---|---|
| 파일 주소 | 분자 접근 전 | 파일 선택 |
| 가닥 index | 시퀀싱 후 | 조각 순서 |
| 시료 barcode | run 후 분류 | 샘플 구별 |
- 파일 주소: 특정 파일을 선택하는 프라이머 쌍
- 가닥 index: 파일 안에서 조각의 순서를 식별
- 시료 barcode: sequencing run의 시료를 구별
- 주소·index·payload 길이의 예산
공통 프라이머와 파일별 프라이머
- 전체 풀 증폭용 공통 결합 부위
- 파일마다 다른 주소 프라이머 쌍
- 공통 영역의 오선택과 교차 반응 가능성
- 주소 설계와 payload 제약의 연결
Organick 연구의 대규모 접근
- 2018년, 35개 파일의 PCR 기반 접근
- 전체 약 200 MB 규모의 저장 연구
- 파일별 프라이머를 이용한 선택과 복원
- 접근 성공은 선택성과 복호를 함께 평가
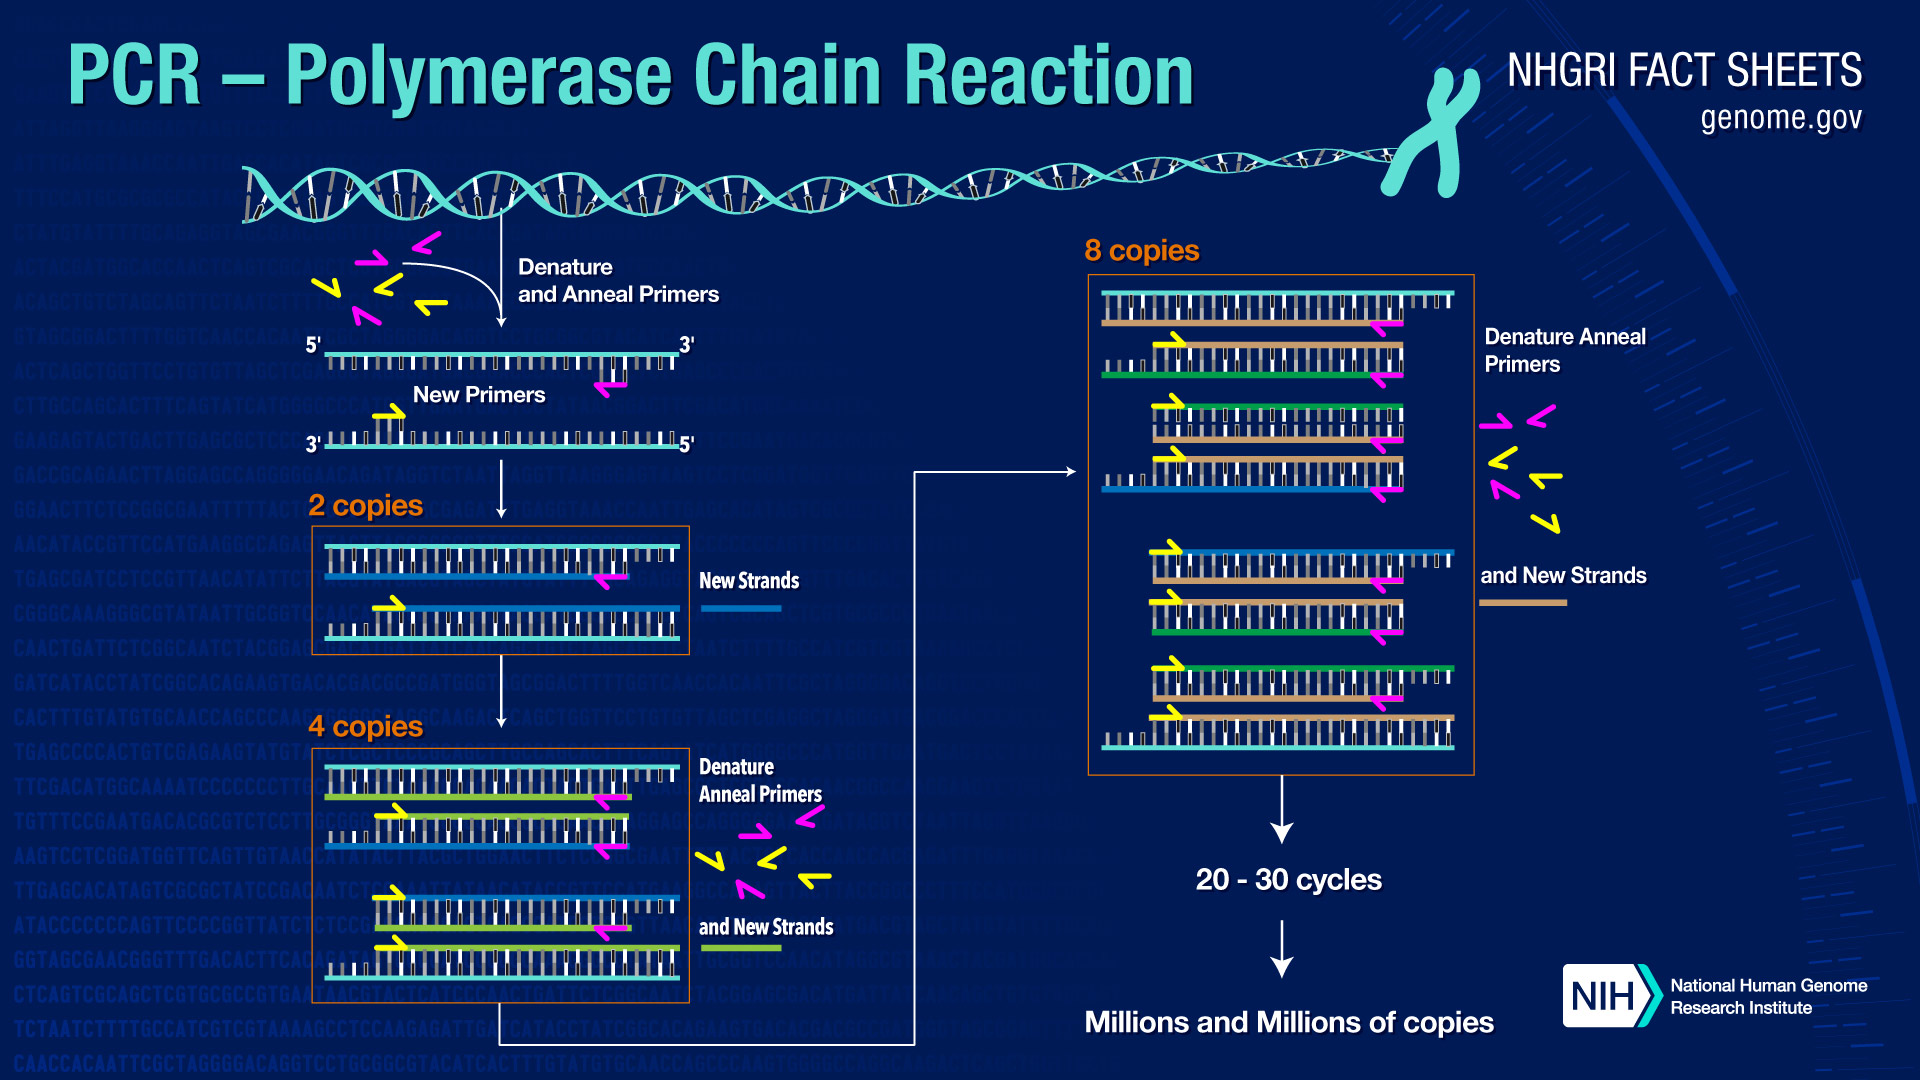
PCR 반응의 구성

- Template DNA 주형
- Forward primer와 reverse primer
- DNA polymerase, dNTP, 반응 완충액
- 프라이머 3′-OH에서 새 가닥 신장
https://www.genome.gov/about-genomics/fact-sheets/Polymerase-Chain-Reaction-Fact-Sheet
Denaturation 변성
- 이중가닥의 분리
- 염기쌍 사이 상호작용의 해리
- 공유결합 골격의 절단과 구분
- 다음 프라이머 결합을 위한 주형 노출
- 이중가닥 주형 준비
- 가열에 따른 가닥 분리
- 단일가닥 주형 노출
Annealing 어닐링
- 프라이머와 상보적인 주소 부위의 결합
- 온도, 서열, 염 농도에 따른 결합 차이
- 두 프라이머가 정하는 증폭 구간
- 비특이 결합과 primer dimer의 점검
Extension 신장
- 기존 프라이머 3′-OH와 유입 dNTP의 반응
- 새 가닥은 5′→3′ 방향으로 증가
- 주형의 상보 서열 복제
- 효소와 길이에 따른 반응 시간
- 프라이머-주형 결합
- 상보 dNTP의 활성 부위 결합
- 인산다이에스터 결합 형성
- 새 3′-OH에서 다음 도입
초기 사이클과 길이 제한 산물
- 첫 사이클: 한쪽 프라이머에서 시작한 긴 산물
- 이후 사이클: 양쪽 끝이 정해진 산물 증가
- 양 프라이머 사이 구간의 선택적 축적
- 이상적인 지수 증가와 실제 반응의 차이
PCR 증폭의 수학
- 초기 사본 수 N0
- 사이클 효율 E: 0≤E≤1의 단순 모형
- c회 후 N=N0(1+E)^c
- E=1의 이상 조건에서 N=N02^c
N(c) = N₀(1 + E)^c
확인·실습 문제
N₀=100, E=1, c=10인 이상 모형의 산물 수 계산
프라이머 쌍의 선택성
- 파일 A의 두 주소에 맞는 프라이머
- A의 분자들이 우선 증폭
- 파일 B·C의 비표적 분자는 반응 후에도 존재 가능
- 접근의 목표: 표적 read 비율의 증가
PCR 편향과 반복 접근
- 서열별 증폭 효율 차이
- GC 함량, 이차구조, 길이의 영향
- 많은 사이클의 편향·오류 축적
- 원본 master pool과 읽기용 aliquot의 구분
무작위 분주와 Poisson 모형
- 평균 사본 수 λ인 분주를 가정
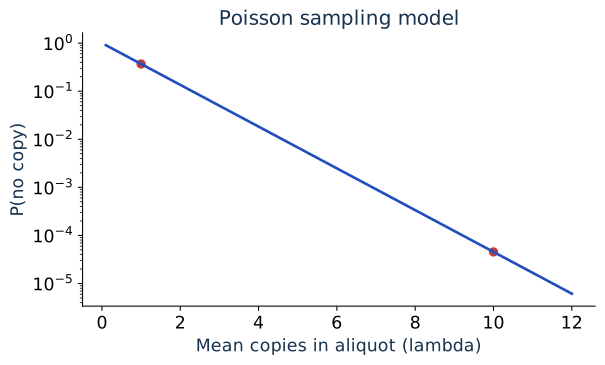
- 특정 서열이 하나도 없을 확률: exp(−λ)
- λ=1: 약 36.8%, λ=10: 약 0.0045%
- 균일·독립 분주를 가정한 예제
P(N=0) = exp(−λ)
확인·실습 문제
사본 수가 적은 파일을 PCR 사이클 증가만으로 항상 구할 수 없는 이유 설명
물리적 복잡도와 접근 실험
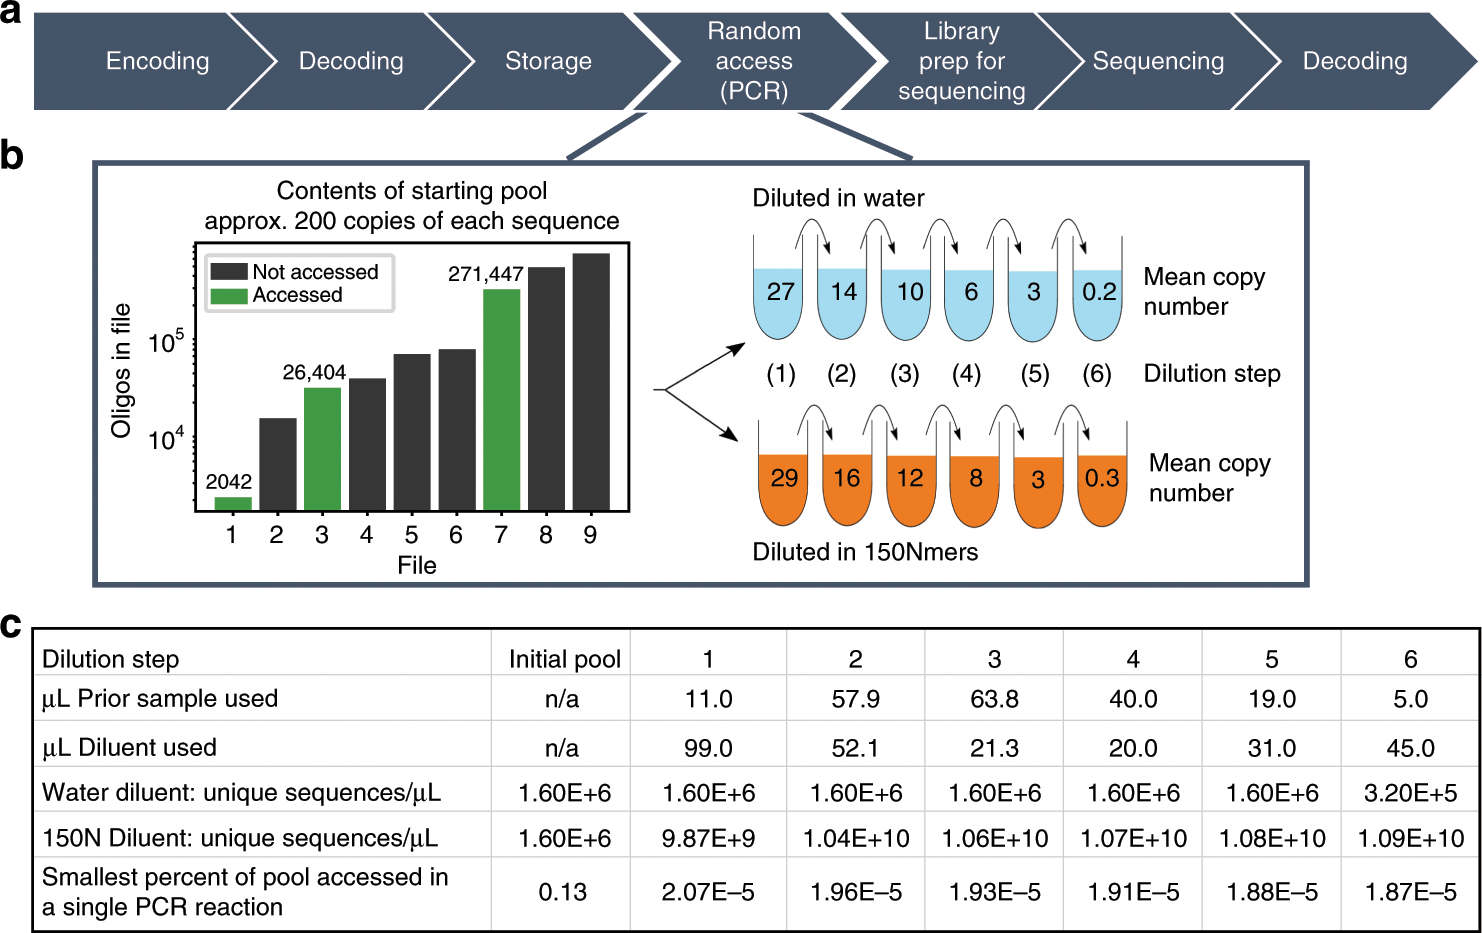
- 많은 종류의 비표적 서열이 섞인 풀
- 표적 주소의 교차 반응 가능성
- 시퀀싱 coverage와 분자 sampling의 분리
- 실험 조건별 복원 성공률 비교
선택 성능의 지표
- Enrichment: 표적 비율의 선택 전후 변화
- Purity: 읽힌 것 중 표적의 비율
- Recall: 필요한 표적 서열의 회수 비율
- File recovery: 실제 파일 복원 결과
실리카 캡슐의 표면 주소

- 내부: 파일 데이터 DNA
- 외부: 파일 특성을 나타내는 DNA 태그
- 형광 탐침으로 태그 인식
- 선택된 캡슐을 분리한 뒤 내부 파일 판독
Boolean search 분자 검색
- 서로 다른 태그에 서로 다른 탐침 사용
- AND: 여러 조건을 동시에 만족하는 캡슐
- OR: 어느 한 조건을 만족하는 캡슐
- NOT: 특정 태그를 제외하는 선택
확인·실습 문제
태그 A·B·C로 (A AND B) NOT C 파일 검색 조건 작성
Hybridization capture 혼성화 포획
- 고정된 탐침과 표적 서열의 상보 결합
- 세척을 통한 비표적의 제거
- 온도·염 농도·서열에 따른 선택성
- 표적 방출 후 증폭 또는 시퀀싱
- 표적-탐침 결합
- 지지체 분리
- 비표적 세척
- 표적 DNA 방출
공간 주소와 분자 주소
- 웰·점·필름 위치로 파일 구분
- 서열 태그로 같은 풀 안 파일 구분
- 물리적 위치와 서열 주소의 조합
- 보존 패키지와 접근 장치의 공동 설계
Nanopore adaptive sampling
- 먼저 들어온 신호를 실시간 판독
- 표적과 맞으면 계속 읽기
- 비표적이면 전압 제어로 읽기 중단·방출
- 분자 전체를 읽기 전 선택하는 방식
자동 DNA 저장·복원 장치

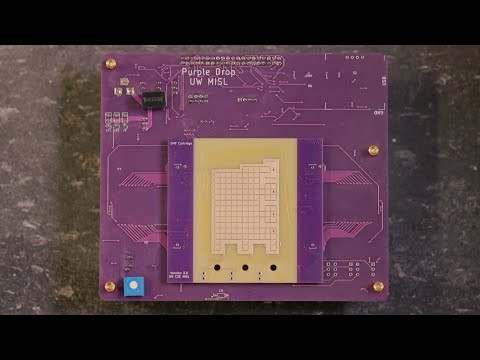
Microsoft Research YouTube에서 보기
영상의 관찰 항목
- 디지털 입력에서 합성·저장·판독을 연결
- 액체 취급 장치와 소량 반응
- 자동화된 동작과 높은 처리량의 구분
- 2019년 UW·Microsoft 공개 시연
https://www.microsoft.com/en-us/research/project/dna-storage/
오선택과 인덱스 오류
- 다른 파일의 DNA가 섞인 경우
- 파일은 맞지만 가닥 index가 틀린 경우
- 시료 barcode 분류가 틀린 경우
- 단계별 검증과 오류정정의 역할
접근 시스템 설계 예제
- 10,000개 파일에서 하나를 선택하는 가상 설계
- 물리적 웰과 파일별 프라이머의 조합
- 표적 비율·사본 수·read 예산의 설정
- 원본 master와 읽기용 사본의 관리
확인·실습 문제
가상 파일 시스템의 주소 구조와 선택 후 검증 절차 설계
접근 후 시퀀싱과 복호
- 선택된 풀의 라이브러리 준비
- 시퀀싱 read와 품질 점수 획득
- 파일·가닥별 분류와 consensus
- 오류정정 후 원본 byte·해시 확인